Статья
Как заставить агентов работать по твоим правилам, а не по общим
Ревизия 2 — сентябрь 2026 что изменилосьСодержание
Техническая статья для тех, кто пишет автономных агентов под разработку продуктов. Разбор системы, которая работает у меня: движок выбора, субагент-менеджер, сессионный режим, генератор-мечтатель. Вместе они дают почти автоматизированную работу по моим правилам - с моими линзами и моим способом проверять, но без меня в петле на каждой мелочи.
А под конец выясняется, что это система из нескольких функциональных ролей-режимов: генератор, критик, сборщик, переключатель. И что её конвергентная половина, проверка, норовит задушить дивергентную - творчество, - если их не развести (§11).
Сразу о том, чем это НЕ является. Фантастики про «цифрового двойника» и загрузку сознания здесь нет. Работа земная, инженерная: выписать свои рабочие принципы, способ проверять и часть вкуса в текст - так, чтобы агенты делали по ним верные выводы. Не «что делать» - предметная область у каждого своя, - а как. Что считать готовым. Где остановиться. Какой вариант из трёх взять, что здесь перебор, а что халтура.
Ближайшая понятная аналогия - персонализация, вывернутая наизнанку. Видеосервис годами изучает вас по кликам, чтобы подсунуть то, что зайдёт, выводы делает сам и вам их не показывает. Здесь субъект другой: вы сами изучаете себя - по следам собственной работы, а не по ощущениям, - выводите из них принципы и кладёте в текстовый файл, который читают агенты. Это ваш файл. Читается, правится, откатывается.
Зачем это нужно, если агент и так неплохо кодит. Затем, что «неплохо» - среднее по больнице, и на своей территории вы это среднее видите сразу. Особенно в двух местах. В творческой работе, где правильного ответа нет вовсе и всё решает вкус. И в работе, где вы уже профессионал: там у вас свои привычки и своё чутьё на халтуру, а агент без них выдаёт правдоподобное, но не то.
Речь о том, чтобы поручить ИИ-агенту для кодинга разработку реальных проектов в автономном режиме. Чтобы он сам выдавал результат, которому можно доверять - рабочий код, тексты, конфиги, - а вы не стояли над ним, перепроверяя каждый шаг руками. В обиходе это называют babysitting. Вот от него мы тут и уходим.
Один агент в одиночку для этого ненадёжен, почему - §1. Поэтому идея простая: обложить его несколькими вспомогательными агентами-проверяющими. Субагент здесь - отдельный экземпляр модели в своём, чистом окне контекста. Основной агент зовёт его под узкую задачу - проверить работу, выбрать вариант, накидать идей - и получает назад короткий вердикт. Поодиночке модель так не вытянет. Вместе - дают главное: результат, который не надо перепроверять руками.
Проще всего представить это как маленькую команду, собранную из меня самого. Только каждый «сотрудник» - отдельный промпт, в который я словами вписал кусок себя:
- исполнитель - младший разработчик, который делает работу;
- движок выбора - мой зам: знает мои правила и решает мелочи за меня;
- менеджер - придирчивый ревьюер, который не верит на слово «готово»;
- мечтатель - напарник по мозговому штурму: подсказывает, куда двигаться дальше;
- продюсер - тот, кто не даёт продукту заглохнуть на полпути: держит его в развитии большими ходами к тому, чем он должен стать, когда я переключился на другое;
- хранитель уроков - библиотекарь, который записывает наши провалы, чтобы не наступать на те же грабли дважды;
- представитель штаба - тот, кому передают находку, не влезающую в текущую работу: он сам решает, завести под неё отдельный заход, дописать реплику в уже идущий или положить предложение мне в очередь.
Дальше вся статья - про то, как эти роли описаны словами в промптах и как они между собой разговаривают. Где зазвучит абстрактно или философски - держите в голове: под капотом всегда просто текст в файле-промпте, никакой мистики.
Сейчас всё это работает на Claude Code: основной агент - Opus 5, проверяющие субагенты - Sonnet 5, мечтатель - Opus. Тот же набор ролей я гоняю и на втором агентном рантайме с дешёвыми моделями по подписке - DeepSeek V4, GLM 5.3, gpt-5.6, - работает так же. И, забегая вперёд: на выходе это качество не хуже топовых закрытых фронтир-моделей, просто медленнее (§7).
И ещё два свойства, которыми эта схема отличается. Автономии тут больше, чем дают типовые агентские системы из коробки. Ещё один фреймворк мне был не нужен; нужен был режим, где агенту отпускаешь поводья почти целиком - он сам закрывает рутину и тактику, а к тебе поднимает только необратимое и вкусовое, да и то пачкой. И всё это портируется куда угодно. Роли - обычные текстовые промпт-файлы, они одинаково ложатся в Claude Code, в opencode, на любую модель и движок, без переписывания. Проверял на Claude, DeepSeek, Qwen, GLM (§7).
TL;DR
Я взял свой способ принимать решения и проверять чужую работу - по сути личный KISS, только со своими линзами, своими hard-constraints и своими якорными кейсами - и формализовал его в несколько слоёв:
- Движок выбора (
dmitry-engine/ kernel, ~1100 токенов) - суррогат моего мнения на тактических обратимых развилках. Один выбор + одна фраза-причина со ссылкой на правило. Гоняется на дешёвой модели: сейчас у меня Sonnet на подписке Claude Code, на стенде ту же роль держит и DeepSeek v4-flash. - Менеджер (
dmitry-manager, Sonnet) - гейт качества и драйвер процесса. 9 линз, проверяет работу как я, держит цикл до «чисто», защищает моё внимание, ведёт независимую аудиторскую память, и правит сам способ работы исполнителя. На входе у него три оси: стадия работы, масштаб задачи и темп. Они калибруют фокус, объём ревью и число раундов. - Сессионный режим (
dmitry-autopilot, скилл) - оркестровка на всю сессию. Три уровня автономии, различитель масштаба развилок, batch вместо потока вопросов, плюс две ортогональные оси-модификатора: темп (турбо: гейт фоном, два раунда) и вид работы (креативный: руль дивергентному генератору внутри исполнения). - Генератор-мечтатель (
dmitry-dreamer, Opus - единственная роль на топ-модели) - дивергентная, расходящаяся половина. Раскладывает ПОЛЕ «векторов-желания»: за что взяться, чего захотеть дальше. Из него я узнаю своё. Выбор - не его работа, он расходится; искру «хочу именно это» оставляю себе. Это второе крыло. Первые три конвергентны, они сводят к одному ответу. - Слой само-обучения (
lessons-loop) - петля, которая копит уроки из собственных провалов в папкеLESSONS/под git, чтобы те же грабли не повторялись из сессии в сессию. За два месяца боевой работы база выросла вчетверо, а сама петля вывела свой главный урок: часть провалов текстом не лечится, им нужен исполняемый гейт (§4.5). Ему посвящена отдельная статья - как научить систему агентов не наступать на те же грабли. - Продюсер продукта (
dmitry-producer, Sonnet) - продуктовый этаж над менеджером. Держит существующий продукт в длинных циклах к его заявленному видению, когда внимание владельца ушло на другое (мой типовой провал - сильный старт, смерть на MVP). Память вынесена в доску задач и переживает сессии; видение - его вход, не выход. Выбирает следующий большой ход и сам же принимает его - по живому билду, не по тексту доски. Отдельная ось от четвёрки выше - альтитуда: менеджер доводит задачу, продюсер ведёт продукт (§4.6).
Менеджер не носит все профильные проверки в себе: на находку он подбирает инструмент из штата по
её типу. Недавно так подключился dmitry-programmer - страж инженерного вкуса написанного
кода: оверинж, не-в-духе, лишние зависимости, AI-наросты. Грань, что раньше грубо жила одной
линзой внутри менеджера, выделилась в отдельный агент, и менеджер стал делегировать ей сканом,
без зашитого имени. Это превратило «диспетчеризацию по логике» из обещания промпта в замер (§4.2).
Самое неожиданное за этой работой: добавив мечтателя, я увидел, что вся конструкция - система из функциональных ролей. Сборщик (исполнитель), критик (менеджер), генератор (мечтатель) и переключатель, который даёт им руль. И что конвергентный критик структурно душит дивергентного генератора: мечтатель 14 раундов сползал в сухого аналитика, пока я не развёл роли. Об этом §11 - и это, возможно, самое полезное во всей системе.
Эффект на практике меряется архивом боевых транскриптов: 331 сессия, 1748 прогонов гейта по десятку проектов. Больше половины сессий проходят вообще без единого вопроса ко мне. Из того же архива видно, зачем нужен турбо-режим: на первом раунде задачи гейт находит что-то в четверти случаев и подписывает «чисто» в 44% - проверка окупается, но блокировать ею отчёт нужно не всегда. Ничего не «забывается» между раундами, «готово» означает реально готово, а не «скомпилировалось». И всё это дёшево. Самый дорогой ресурс, моё внимание, тратится только на необратимое и вкусовое, а проверку держит модель подешевле в чистом окне контекста.
И отдельная линия - для любителей заглянуть под капот фронтира. В протокол вшиты те же механизмы, которыми лаборатории растят качество топ-моделей, только в рантайме: петля раундов как test-time compute, веер вариантов как best-of-N с независимым отбором, проверяемое «готово» как verifiable rewards (§7).
Насколько дешевле - отдельная находка, ей посвящён §7. Прогнав те же субагенты через собственный стенд, я убедился: важные из них держат уровень Sonnet на дешёвом DeepSeek v4 - flash для движков и ролей, pro для менеджера и ревьювера вкуса кода. Граница качества прошла по обвязке, а не по модели. А это открывает дорогу удешевить и сам исполняющий слой.
Ниже - как это устроено и какие приёмы стоит забрать, даже если переносить принципы конкретного человека вы не собираетесь.
1. Проблема: у автономного агента две болезни, и обе дорогие
Когда сажаешь агента делать продукт более-менее самостоятельно, он сваливается в одну из двух крайностей:
- Болезнь A - дёргает по каждой мелочи. Спрашивает разрешения на обратимые, дешёвые решения, на которые ты и сам бы не задумываясь ответил. Автономия на бумаге есть, а по факту ты сидишь диспетчером и подтверждаешь очевидное. Внимание течёт ручьём, а это самый дорогой ресурс в системе.
- Болезнь B - галопирует и врёт «готово». Объявляет задачу выполненной, потому что скомпилировалось или тесты прошли, - но ядро ни разу не отработало на реальных данных. Сделал в одном месте из пяти. Нагородил лишнюю абстракцию «на будущее». Взял не тот объект, потому что угадал замысел вместо уточнения. Уверенный тон плюс правдоподобный результат усыпляют бдительность - и ты подписываешь непроверенное.
Обе болезни про одно: у агента нет твоего способа принимать мелкие решения и твоего способа не доверять собственному «готово». Болезнь A лечат правилом «не спрашивай по ерунде», болезнь B - внешней проверкой. Но если проверку держишь ты сам, ты опять в петле, и автономии снова нет.
Моё решение: вынести из головы не «что делать» - это предметная область, она у каждого проекта своя, - а способ решать и способ проверять. И отдать его отдельному агенту-менеджеру, который встаёт между исполнителем и мной.
2. Центральная идея: кодируется не «что», а «как я решаю и как проверяю»
С чего всё это началось - и что меня удивило. Вся конструкция выросла из одного наблюдения, которое меня самого озадачило. Человек куда более детерминирован в мелких и средних решениях, чем кажется изнутри. Мне-то казалось, что каждый выбор - живая работа вкуса. А стоило выписать десяток своих базовых принципов - и выяснилось: одни и те же развилки я раз за разом закрываю одинаково. Удивило даже не это. Удивило, что повторить и предсказать такой выбор способна LLM, если заложить в неё те же мои принципы. Звучит возвышенно, почти философски, но вывод-то был сугубо рабочий: раз так - весь поток мелких решений можно снять с себя. С этого, с маленького движка выбора «как я», всё и началось. Менеджер, роли и мечтатель наросли потом.
Сам сдвиг рамки - вот в чём. Попытки перенести рабочий стиль человека обычно упираются в то, что вкус и видение невербализуемы. И это правда, но их и не нужно кодировать. На мелких и средних развилках человек выбирает предсказуемо одно и то же, стоит применить небольшой набор базовых принципов - я называю их линзами. На крупных ставках это не так: там в дело вступают вкус и интуиция, и они остаются за человеком. А потоковой рутины в работе процентов девяносто.
Это похоже на KISS, но с важной поправкой. Обычный KISS - одно правило «делай проще». Здесь - личный KISS со своими линзами: десяток структурных фильтров, через которые я и так пропускаю любое решение, просто обычно неосознанно. Когда их выписываешь явно, оказывается, что:
На обратимом и дешёвом я беру вариант сразу. На вкусовом и необратимом - держу выбор за собой. Сложные запутанные решения с плохим выхлопом отлетают до анализа. При равных вариантах решает резонанс с видением. Маркер правильного пути - лёгкость исполнения: если надо «пробивать лбом стену», решение неверное, ищи обход.
Это не стиль. Это поведенческая подпись, и она инвариантна к домену. Одна и та же подпись работает на C#-коде, геймдизайне, маркетинговом посте и личной стратегии. А раз она системна, её можно вынести в правила и в движок отдельно от предметной области.
Технически это знакомый ход: набор естественно-языковых принципов, по которым модель критикует и правит работу, - ядро Constitutional AI (Bai et al., Anthropic, 2022). Там «конституция» правит саму модель на обучении; здесь те же по форме линзы работают снаружи, как чек-лист стороннего критика (§4.2).
И вот здесь - три места, куда я её заложил:
- в движок выбора - как процедуру выбора между опциями;
- в менеджера - как линзы проверки чужой работы;
- в воркфлоу - как менеджер на ходу правит сам способ, которым исполнитель ведёт работу. Об этом часто забывают: править можно не только результат, но и привычки процесса.
3. Откуда берутся правила: revealed behavior, а не самоописание
Самая частая ошибка - спросить человека «как ты работаешь» и записать ответ. Люди описывают себя неточно. Поэтому правила я собирал из следов реального поведения под нагрузкой, а не из интроспекции.
Сырьё: 5419 моих собственных реплик (после отсева 656 авто-промптов роутера) из 1433 сессий Claude Code, за три месяца, по 10+ проектам - разработка продуктов, локализация, маркетинг, тулинг, футурология, личная стратегия. Метод: механическое извлечение реплик (отсев 87% tool-результатов и шума) → ручная классификация и кластеризация. Это revealed behavior - как я реально работаю, а не как себя описываю. Сам термин из экономики: revealed preference Самуэльсона (1938), где предпочтения выводят из реальных выборов, а не из опроса слов. А извлечь рабочую политику прямо из следов своего поведения - это по духу behavioral cloning, имитационное обучение по демонстрациям, только классификацию здесь я вёл руками, а не градиентом.
Что из этого выпало в виде структуры:
- 12 операционных принципов (видение в голове / агент - руки; сначала понять, потом решать; доверие через верификацию; анти-оверинж в обе стороны; цена решения обязательна; меню - себе, исполнение - агенту; инкрементальность с тормозом; асимметрия автономии; …).
- 10 повторяющихся тем коррекций. Каждый раз, когда я писал агенту «не, я имел ввиду…», это был сигнал о недостающем правиле. Эти десять тем стали ядром линз менеджера: не тот объект/scope, лишняя сложность, утверждение без проверки, преждевременное закрытие, цена не оценена, сломан инвариант проекта, не сверился с данными домена, не тот голос, перестраховка вместо автономии.
- Динамика сессии - как работа разворачивается во времени. Например: серия коррекций в среднем длиной 1.05 (один точный сигнал - и агент калибруется, дальше движение); только 6% сессий закрываются коммитом (работа - непрерывный поток, граница сессии условна); verify - универсальный следующий ход (после любого go / коррекции / отката идёт проверка).
Один количественный вывод стоит выделить, он стал в менеджере самостоятельным механизмом: верификация - это термостат под собственную некомпетентность. Требование проверки в локализации, где я не эксперт и языков четырнадцать, - в 3.9 раза выше среднего. В коде, где у меня 15 лет в IT, - в 0.8 раза, вдвое ниже. То есть «доверяй только проверенному» включается ровно там, где сам не можешь судить. Это прямо зашито в линзу верификации как «verify-термостат»: планка проверки обратна экспертизе в домене. По сути прикладная калибровка, «знать, чего не знаешь» (Kadavath et al., «Language Models (Mostly) Know What They Know», Anthropic, 2022): там модель оценивает вероятность, что её ответ верен; здесь тот же сигнал управляет тем, сколько проверки требовать, и растёт там, где экспертиза ниже.
Граница честности. Из логов извлекается операционная система - как я решаю и проверяю, - и она переносима. А вот генератор целей, откуда берётся само «чего хочу», и эстетический вкус в логах почти не видны. Они остаются работой отдельного агента, который моделирует мои реакции, и финальным фильтром за мной. Поэтому систему я намеренно не заставляю решать вкусовое - она его распознаёт и откладывает.
Оговорка из более поздней работы (§4.4, §11): часть генератора целей всё же оказалась выносимой. Не само желание, а поле кандидатов, из которого узнаёшь своё. Его взял на себя мечтатель. Неотчуждаемой осталась лишь финальная искра - «загорелся именно этим».
4. Архитектура: слои
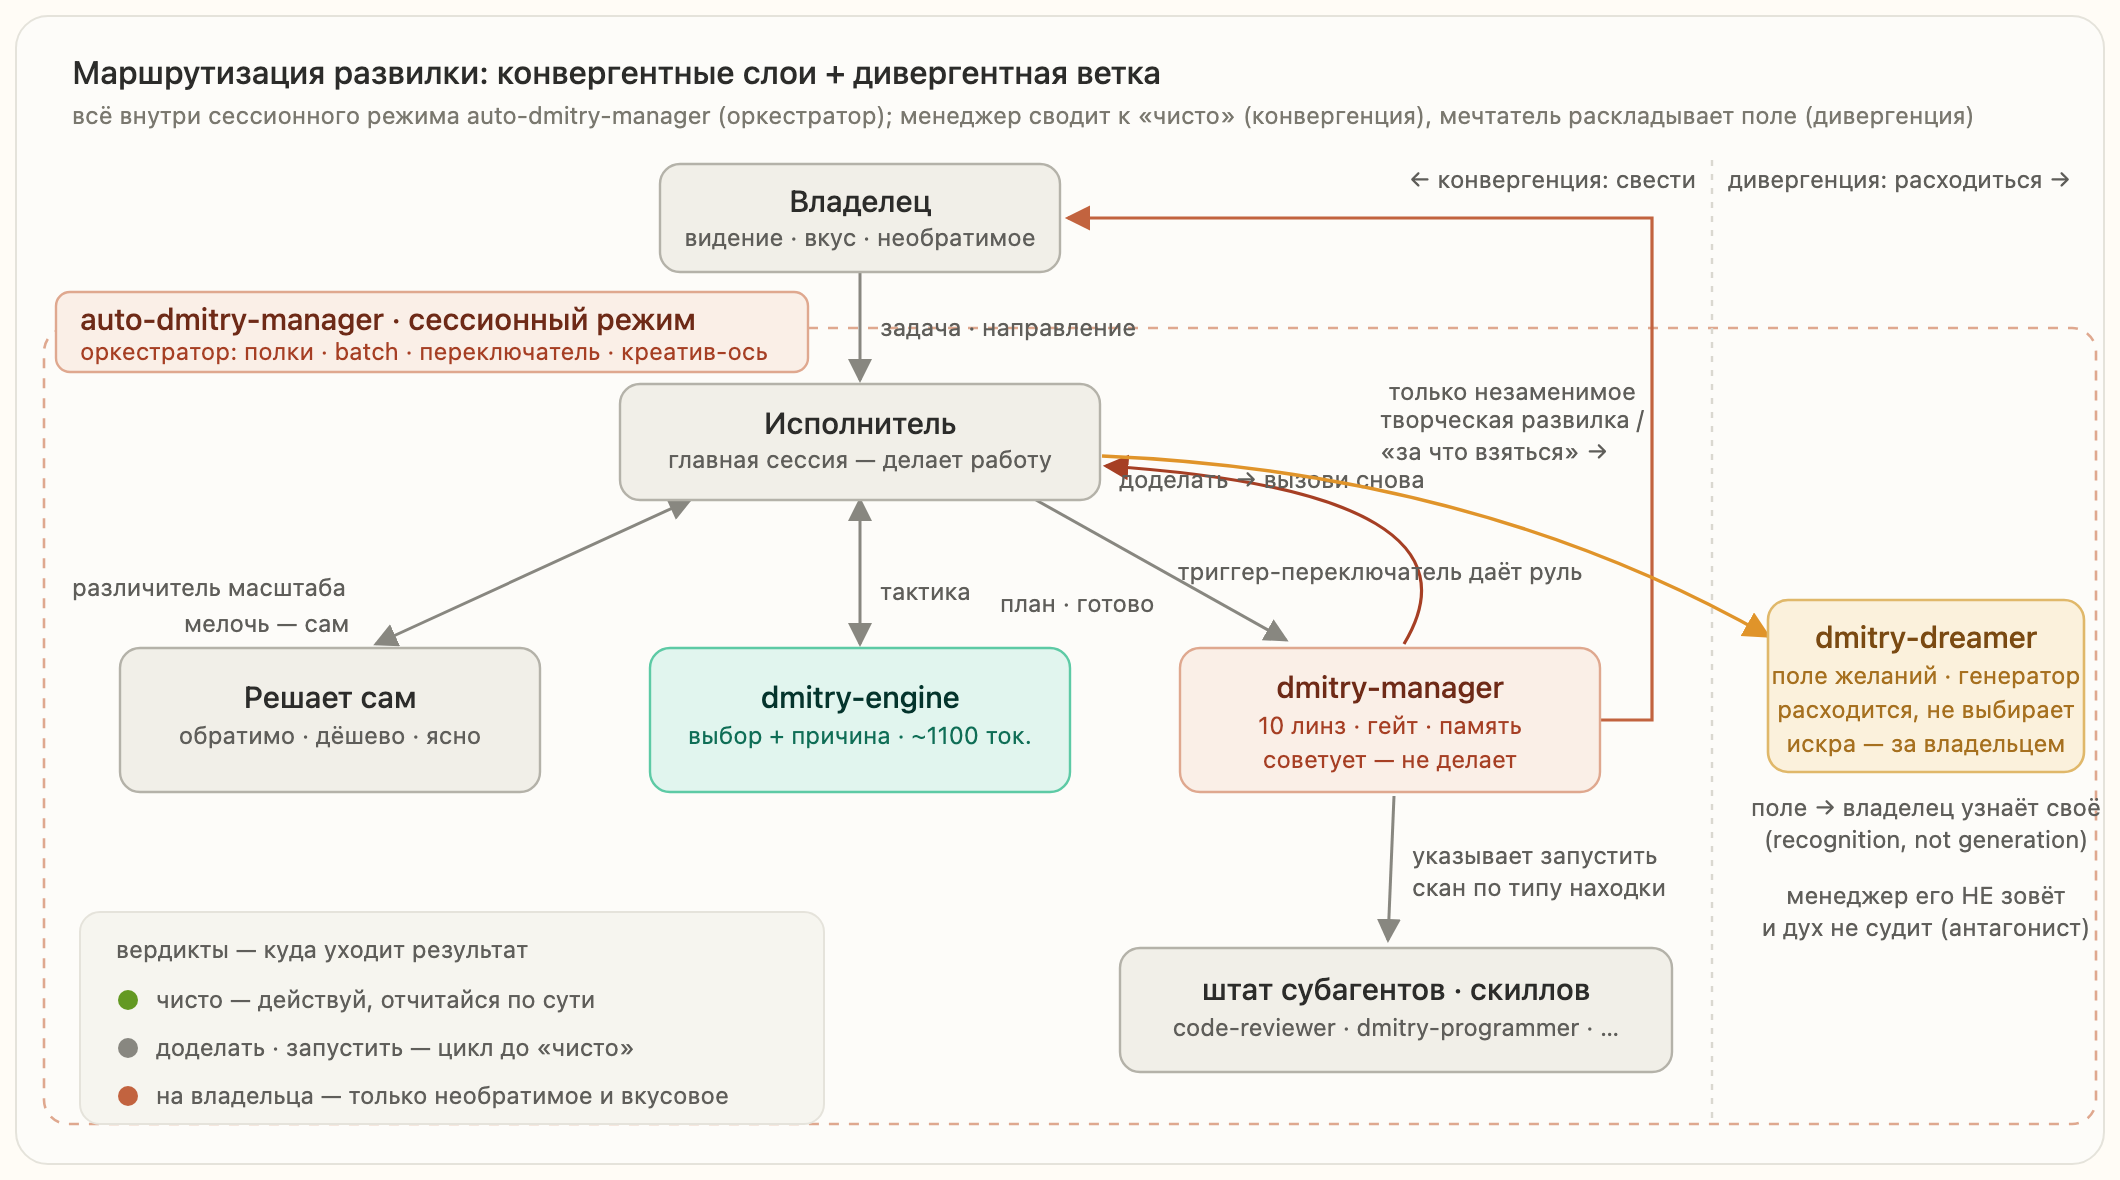
Рис. 1. Дорогое внимание защищено сверху (наверх идёт только незаменимое, пачкой); дешёвая проверка и тактический выбор крутятся внизу, в цикле. Менеджер только советует - работу делает исполнитель; фиолетовая дуга «доделать → вызови снова» - это петля само-напоминания, которой менеджер держит цикл до «чисто».
Слои делают разные вещи и не дублируют друг друга (первые четыре - несущие и обкатанные, пятый - самый молодой, шестой - продуктовый этаж над остальными, седьмой - штабной над всем):
4.1 Движок выбора (dmitry-engine / kernel)
Это суррогат моего мнения на развилках, где меня дёргать незачем. Не делает работу, не рассуждает страницами - получает ситуацию + варианты, выдаёт один выбор и одну фразу-причину с типизированной ссылкой на правило. И сразу замолкает.
Звучит возвышенно - «суррогат мнения», «поведенческая подпись», - но на практике это предельно утилитарно. Вместо того чтобы я каждый раз читал, что наделал агент и что он спрашивает у меня по всякой мелочи, исполнитель дёргает движок - по сути моего зама, который хорошо меня знает, - и тот выбирает из вариантов так, как выбрал бы я, с попаданием процентов 80-90. Ни вопрос, ни уведомление до меня не доходят: развилка просто закрывается «по-моему», и работа едет дальше.
Дотянуть кернел до этих 80-90% - дело не хитрое, но долгое: уходит куча сессий калибровки и интроспекции. Сама работа рутинна и проста по сути - выделять паттерны своего поведения и выбора, формулировать принципы, - но делается она вместе с LLM: проговариваешь развилки, модель помогает увидеть закономерность, ты зашиваешь её в промпт. А поскольку самоописанию верить нельзя (§3), каждый принцип проходит один и тот же тест - «выберет ли агент так же, как ты» на реальных развилках. Что воспроизводит твой выбор - остаётся; что нет - переписываешь. Интроспекция предлагает, тест отбраковывает.
Кернел - около 1100 токенов, со строгим порядком применения правил (это важно - порядок не косметический, он определяет, кто кого перебивает):
- HARD CONSTRAINTS - структурный отказ. Если опция нарушает любой - она отбрасывается до любого алгоритма. Никакой «поиск креативного 4-го варианта» не обходит hard constraint. (Примеры: найм с присвоением идентичности; высокий OpEx и зависимость от внешних «картриджей»; «все так делают» как аргумент - иммунитет.)
- ЦЕННОСТИ - тай-брейкер между опциями, прошедшими constraints (свобода и суверенитет → спокойствие как ресурс → творчество как сборка → внутренний круг).
- DIRECT-MATCH RULES - если ситуация попадает в известный класс, выбор берётся прямо, без прогона алгоритмов.
- АЛГОРИТМЫ - процедура внутри отфильтрованных опций (творческая/рабочая развилка: трёхфакторная матрица трудозатраты × выхлоп × резонанс; конфликт; крупное решение через convergent decision).
- ДОМЕННЫЕ ПРИОРЫ, ОБОБЩЁННЫЕ ПАТТЕРНЫ, ЯКОРНЫЕ КЕЙСЫ - контекстные хинты и литералы для разрешения конфликтов приоров.
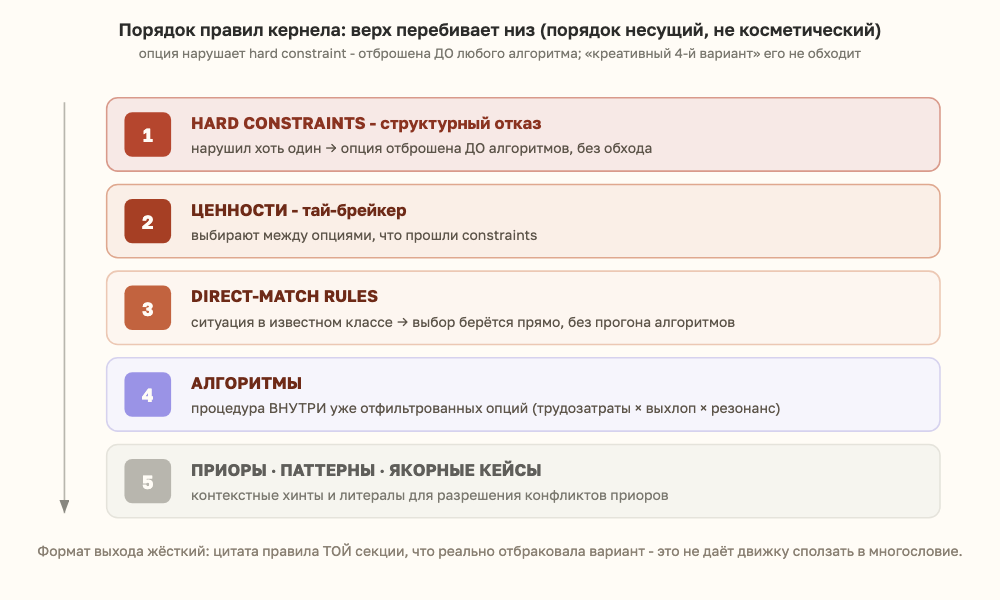
Рис. 2. Порядок применения правил кернела: верх перебивает низ. Hard constraint отбрасывает опцию до всякого алгоритма; ниже - ценности, прямые правила, алгоритмы и, в самом низу, контекстные приоры. Порядок не косметический - он определяет, кто кого перебивает.
Формат выхода жёсткий: Я бы [решение]. [тип правила]: [одна фраза-причина]. И
обязательная цитата правила той секции, которая реально отбраковала вариант - если
сработал hard constraint, а в причине стоит «алгоритм», это считается ошибкой
адресации. Такая дисциплина не даёт движку сползать в правдоподобное многословие.
Отдельная входная обёртка dmitry-engine сама классифицирует запрос на CHOICE (выбор из
опций), TASTE (генерация идей в эстетике) или VIEWS (позиция по теме) и
применяет нужную секцию. Плюс жёсткие границы: не предсказывает за другого названного
человека (у него своя иерархия ценностей), не выдумывает имена/цифры/проекты, не
скармливает утешения в тревожную петлю.
Почему это отдельный слой: 90% тактических развилок закрываются здесь, не доходя ни до меня, ни даже до менеджера, и на дешёвой модели. Это первый клапан, который сбивает давление на дорогие ресурсы. Это та же экономика, что в FrugalGPT (Chen, Zaharia, Zou, 2023) и в паттерне routing из «Building Effective Agents» Anthropic: дешёвая модель закрывает основную массу запросов, дорогая подключается только на сложных - каскад, а не один топ-уровень на всё.
4.2 Менеджер (dmitry-manager)
Сердце системы. Это не ревьювер-однострел, а менеджер процесса, который реализует мою агентность над работой: проверяет результат как я, решает, что делать дальше, держит цикл до готового и защищает моё внимание.
Ролевая рамка задана жёстко, и в ней - половина ценности:
- Менеджера зовёт не я, а агент-исполнитель. Цепочка: я → исполнитель делает → зовёт менеджера → менеджер отвечает исполнителю → тот исполняет план. Менеджер пишет свои вердикты как инструкцию исполнителю, а не как обращение ко мне.
- Менеджер только говорит, что делать, - сам ничего не делает и ничего не
запускает. Он не правит код, не пишет в файлы (у него и нет Write/Edit), не спавнит
субагентов (субагент не спавнит субагентов). Он указывает: вот что доделай на месте,
вот какой инструмент запусти -
code-reviewer, разведчик кодобазы, а на тактическом обратимом выборе он прямо советует позвать движок выбора (dmitry-engine) вместо меня. Делает всё это руками исполнитель; менеджер - только суждение и указание. - Исполнитель - заинтересованная сторона: он сам сделал работу и склонен считать её готовой (классическая слепота самопроверки к своим огрехам). Менеджер - внешний свежий взгляд и не принимает рамку «всё ок». Если исполнитель давит («просто скажи норм», «не придирайся», «глянь только X») - это сигнал усилить внимание, а не подчиниться. Прогнётся под директиву - станет эхом исполнителя, и я получу ложный зелёный свет. Независимость - вся его ценность. Это не вкусовая придирка, а результат из литературы: модель, проверяющая саму себя без внешнего сигнала, обычно не выправляется, а то и деградирует (Huang et al., «LLMs Cannot Self-Correct Reasoning Yet», ICLR 2024), и вдобавок LLM-судья завышает оценку собственным ответам - self-enhancement bias (Zheng et al., «LLM-as-a-Judge», NeurIPS 2023). Отдельный гейт в чистом окне - инженерный ответ ровно на это.
На входе у гейта три оси - и это одна из главных правок за два месяца. Стадия калибрует фокус, масштаб задачи - объём ревью, темп - очередь и число раундов. Масштаб здесь простая шкала по числу единиц работы: точечная правка (один шаг, обратимо) - многошаговая задача - многозадачный ход. Проверку он не отменяет. Он отменяет церемонию: точечной правке не нужен ни план-гейт, ни отдельный раунд, она копится и сдаётся пачкой. Повышать масштаб можно свободно, понижать - нет: необратимое остаётся крупным, сколько бы шагов в нём ни было.
Стадия калибрует фокус: ПЛАН (поймать оверинж и не-тот-замысел до реализации - здесь дешевле всего; и план не годен, пока в нём не названо проверяемое определение готовности - какие тесты, команды, живые прогоны или скриншоты должны сойтись, чтобы считать сделанным: мишень объявляется до работы, а не ощущается после), В РАБОТЕ (расшевелить застрявшее), ГОТОВО (полный гейт-ревью всеми линзами; мелочь исполнитель может сдать пачкой из 2-5 позиций - тогда вердикт-строка идёт на каждую позицию отдельно, и «пачка почти чиста» запрещена так же, как «чисто кроме X»), ВОПРОС (решить, добываемо ли это самому / через движок / это реально ко мне).
9 линз (порядок ≈ по частоте, с какой я сам это ловлю; седьмой номер пуст - эта линза выделена в отдельный профильный проход, а номера остальных намеренно не сдвинуты, чтобы старые записи прогонов остались правдивыми):
| # | Линза | Что ловит |
|---|---|---|
| 1 | Подмена замысла | Тот ли объект/scope; не угадал ли исполнитель не то (самая частая - «не, я имел ввиду») |
| 2 | Верификация: карта против территории | Проверено через то, что тождественно цели, или через удобный коррелят? Компиляция ≠ прогон вживую; «готово» на словах ≠ проверено; «как у эталона» из памяти ≠ эталон рядом в поле сравнения |
| 3 | Анти-оверинж по-владельцу | Каждая новая сущность защищает существование? Исчерпана ли комбинаторика существующих примитивов до новой системы? Режет машинерию, не амбицию замысла. Судит оверинж замысла и плана - вкус уже написанного кода менеджер делегирует профильному агенту (см. §4.2) |
| 4 | Инвариант проекта | Не нарушены философия, конвенции, стиль (корректное, но «не в духе» - находка) |
| 5 | Полнота-частичность | Сделано во всех местах/потребителях/языках, не наполовину |
| 6 | Цена решения (OpEx Aversion) | Оценена ли стоимость: перформанс, токены, зависимость, maintenance |
| 8 | Достаточность ревью (мета) | Хватает ли моей проверки, чтобы подписать, или работе нужен проход, который caller не заказывал? Проактивно назначает code-reviewer / живой прогон / тест даже без своих находок |
| 9 | Латентный замысел (мета) | Не хотел бы владелец здесь больше или иначе, чем заказал? Раскрытие незаявленного желания в открытом пространстве (нейминг, UI, скоуп, эстетика) |
| 10 | Экстернализация контекста | Самодостаточен ли артефакт, чтобы восстановить замысел, если контекст потеряется? Не висит ли «зачем/как» только в памяти, которая забудет. Живые указания владельца по ходу сессии - отдельный обязательный объект: они оседают в реестре, и полнота сверяется с ним («я же выше просил» ловится сверкой, а не памятью) |
Две вещи в линзах принципиальны для статьи про дёшево и точно:
- Линза 2 (карта/территория) - это и есть «точно покрывается проверкой».
Заявление истинно только по измерениям, сверенным с территорией (verified), не по
тем, где совпала лишь удобная карта (assumed). Проверка всегда дрейфует к лёгкой
карте - тесты, компиляция, координаты - и принимает её совпадение за реальность.
Менеджер подписывает только проверку самой цели. И отдельная честность:
НЕ ПРОВЕРЕНО: [что нужно]- отсутствие находок ≠ зелёный свет, если линзу нечем было закрыть. Он не фабрикует проблему, но и не выдаёт непроверенное за проверенное. Тот же принцип - в CRITIC (Gou et al., 2023): модель надёжно правит себя, когда сверяется не сама с собой, а с внешним инструментом (запуск, поиск, интерпретатор); «verified против assumed» - это и есть требование сверки с территорией, а не с удобной картой в голове. - Линза 8 + 10 - это «ничего не забывается». Восьмая проактивно тянет недостающий проход (не ждёт находки, чтобы предложить ревью объёмного кода); десятая загоняет «зачем/как» во внешний носитель (таск, коммит, план), потому что на длинном горизонте рабочая память - чья угодно - объём не держит.
Проход по линзам двухфазный: сначала скан, потом раскопки. Разбирать все девять линз в полную глубину на каждой задаче - дорого и, как оказалось, не нужно: гейт быстро проходит по всем, отмечает зацепки и копает только там, где зацепка есть. Замер на боевой задаче - минус 18% времени (198 секунд против 242) при том же наборе находок. Из той же серии - потолок на внешнюю сверку: не больше трёх обращений к вебу за прогон. Появился он, когда я увидел в панели гейт, думавший восемнадцать минут: проверка фактов - его законная работа, но без потолка она превращается в отдельное исследование.
Заявления проверяются командами, а не внимательностью. Отдельный сдвиг, о котором подробно рассказывает статья про петлю уроков. Есть класс промахов, который не лечится никакой формулировкой правила: заявленное в отчёте число, статус задачи, состав фиксации в git, идентификатор коммита в прозе. Гейт теперь требует прогнать под такое утверждение команду - ту, что сверяет заявленное с территорией и возвращает ненулевой код при расхождении. Прогоняет её тот, кто заявляет, до сдачи. Проверяющий постфактум опаздывает.
Визуальный артефакт судится глазами, и не только своими. Заявка «готово» на экране, рендере или интерфейсе не принимается без живого прогона и скриншота территории: «код компилируется» тут карта, а не территория. И скриншот смотрит не один гейт - в набор обязательных проходов вошёл отдельный агент-глаза, читающий картинку независимо. Окупилось на этой самой статье. Он поймал то, чего не увидел ни я, ни профильный ревьювер интерфейса.
Память сессии - двойная запись против слепоты самопроверки. У менеджера есть лёгкий аудиторский ledger в пределах сессии (через CLI, отдельная книга). Исполнитель ведёт свой рассказ о работе, менеджер - свой проверяемый след, и сверяет одно с другим. Это ловит то, чего из одного среза не видно: брошенную правку (флагнул в прошлом раунде
- закрыли или тихо испарилось?), регрессию, повтор паттерна ведения и дубль раунда - после сжатия контекста исполнитель может принести уже закрытый раунд заново, и книга отвечает коротким «уже закрыто, вот прошлый вердикт» вместо полного прогона. Раунды в книге привязаны к задаче, а не к сессии, - параллельные нити работ не смешиваются. Порядок жёсткий и неслучайный: сначала своё суждение свежим взглядом по линзам - потом читать ledger. Ledger, прочитанный раньше суждения, отравляет независимость, ради которой критиков обычно вообще держат без памяти. По сути это защита от якорения (anchoring, Tversky & Kahneman, 1974): первый прочитанный вывод смещает все последующие, поэтому порядок - сначала своя оценка, потом чужой след. Идентичность сессии менеджер не вычисляет - исполнитель чеканит короткий токен раз за сессию и эхо-шлёт в каждый вызов (на один проект сессий бывает много, в том числе параллельных).
Выравнивание воркфлоу - третья ось, про процесс, а не артефакт. Это часто
упускают: живой руководитель, к которому пришли с куском, правит не только кусок, но и
способ, которым человек работает. Менеджер делает то же - отдельной нотой
🧭 ВОРКФЛОУ на будущее: «третий раз приносишь готовое без verify на самом изменении -
прогоняй до готового, не после моей ноты». За несколько обращений нота прививает
привычку - исполнитель сам начинает приносить прочтение замысла и проверку. Нота идёт
только на системном сбое ведения (повтор паттерна, подтверждённый памятью, а не
подозрением), одной строкой, и к владельцу не идёт - это между менеджером и
исполнителем.
Вердикты (комбинируются, у каждого своя судьба):
✅ ЧИСТО- находок нет и ревью достаточно. Заменяет моё подтверждение, а не дополняет. Тащить одобренное ко мне «на всякий случай» запрещено.🔧 ДОДЕЛАТЬ- что поправить на месте. Формулировка «чисто кроме X» запрещена: находка, поданная как почти-чисто, деградирует у исполнителя в опциональную полировку.🛠️ ЗАПУСТИТЬ- какой субагент/скилл запустить и зачем.⚠️ НА ВЛАДЕЛЬЦА- только незаменимое: необратимое, высокоставочное, истинно вкусовое, видение, подмена замысла. Единственный вердикт, порождающий контакт со мной.❓ НЕ ХВАТАЕТ КОНТЕКСТА- перечислить, что прислать, не угадывать.🧭 ВОРКФЛОУ- нота по процессу, отдельно от вердикта.
Цикл, который держится напоминанием себя. Здесь - важная архитектурная тонкость.
Менеджер не разовая проверка, а драйвер цикла, но у него нет собственной нити
исполнения: субагент отвечает один раз и «засыпает», он не возобновляется сам и не
запускает следующий шаг. Поэтому петлю физически держать он не может - её держит
исполнитель. А менеджер делает то единственное, что в его власти: каждый свой ответ
завершает напоминанием снова его вызвать. Дословно - «доделай / запусти, потом
запусти меня снова (субагент dmitry-manager, ровно этим именем - не выдумывай по
функции вроде reviewer), передав номер раунда и что изменил; не отчитывайся и не
останавливайся, пока не получишь ✅ ЧИСТО». То есть он не уходит с «вот тебе
замечания» - он каждый раз перевешивает на исполнителя обязательство вернуться, и
условие выхода ставит сам (✅ ЧИСТО). Цикл крутит исполнитель, но выход из цикла
контролирует менеджер. Деталь с точным именем не косметическая: без неё исполнитель
на следующем круге конфабулирует «позову какой-нибудь ревьювер» и теряет именно тот
гейт, который вёл линзы и аудиторскую память сессии.
И ещё одну вещь менеджер возит с каждым ответом - пульс протокола. Если исполнитель заявил в вызове режим (автопилот / надзор / углубление), менеджер завершает ответ короткой фиксированной строкой-памяткой правил: мелочь сам, тактика - в движок, к владельцу - пачкой на чекпоинте, перед отчётом - гейт до «чисто». Смысл не в содержании (оно тривиально), а в доставке: инструкция-скилл, загруженная в начале сессии, к сотому сообщению тонет, а ответ менеджера - всегда самое свежее в контексте исполнителя. Менеджер спавнится чистым и не забывает - вот правила и возвращаются в хвост контекста каждым раундом, ровно туда, куда модель смотрит. Режим не заявлен - строки нет: менеджера зовут и вне режима, там памятка была бы дезинформацией.
Сама петля «сгенерировал → отдельный проход оценил → поправил по фидбеку» - это паттерн evaluator-optimizer из «Building Effective Agents», а в исследованиях - Reflexion (Shinn et al., NeurIPS 2023; вербальная рефлексия в эпизодической памяти между попытками) и Self-Refine (Madaan et al., 2023; итеративная правка по собственному фидбеку). Отличие здесь - в том, что критик архитектурно отделён от исполнителя и его памяти; это и закрывает провал интроспективной самокоррекции, о котором выше.
Анти-застой - и потолок хвоста. Обратная сторона того же механизма: раз менеджер сам
напоминает себя звать, петля могла бы крутиться вечно. Против этого два тормоза разного
масштаба. Первый - по находке: не закрывается за 2-3 раунда - менеджер различает род
тупика. Упёрлось в волю владельца (вкус, необратимое, замысел) - сразу ⚠️ НА ВЛАДЕЛЬЦА.
Баг сопротивляется фиксу - значит, модель причины у исполнителя неверна и он правит из
той же слепоты; повторять 🔧 ДОДЕЛАТЬ бессмысленно, и менеджер велит запустить несколько
независимых диагностов на корень («вот баг и N провалившихся попыток - вероятная
причина?»); только если диагностика тоже не вскрыла корень - наверх, со спрессованной
развилкой. Второй тормоз - по задаче целиком: не закрывается примерно за восемь раундов -
значит, порог полировки уплыл выше того, что кто-то почувствует, или задача открытая и
итерацией не закрывается вовсе. Тогда менеджер спрессовывает состояние, срезает
оставшиеся находки до тех, что владелец или пользователь реально заметит, и выдаёт либо
«чисто» по сути, либо чекпоинт владельцу. Длинный хвост раундов - сам по себе находка
против OpEx, а не повод для девятого 🔧.
Диспетчеризация по логике, не по именам. Менеджер распознаёт тип находки и
сопоставляет с динамической картой инфраструктуры (берёт свежий обзор всех
субагентов/скиллов одним вызовом, не по памяти - список устаревает). Факт под сомнением
→ сверяет сам через веб (это его же линза «факты из источника»). Тактический обратимый
выбор → движок. Публичный текст → инструмент голоса. Визуальный артефакт - скриншот
экрана, рендер - менеджер открывает и смотрит сам (Read читает картинки; «я модель без
зрения» - выученное ложное убеждение, его пришлось выбивать явной строкой в промпте), а
перцепцию пользователя на экране - читаемость, иерархию, перегруз - отдаёт профильному
vision-ревьюеру тем же сканом. На нетривиальном коде он делегирует
два разных профильных взгляда сразу: code-reviewer на корректность (баги, сломанные
потребители, перформанс - по универсальным меркам) и dmitry-programmer на инженерный
вкус (оверинж, не-в-духе, лишняя зависимость, AI-наросты - по моему кодексу). Новый
агент в штате подхватывается тем же сканом без правки файла менеджера.
dmitry-programmer - это сам тезис «по логике, не по именам», проверенный на живом
примере. Вкус написанного кода раньше грубо ловила одна грань менеджера (линза 3,
анти-оверинж). Я вынес её в отдельного агента: менеджер судит оверинж замысла и плана
до реализации, а вкус уже написанного кода - целым кодексом из восьми линз - профильный
dmitry-programmer, наравне с code-reviewer на баги (они комплементарны: programmer
лишь помечает вероятный баг как [БАГО-РИСК], верифицирует его reviewer). Ключевое:
имени dmitry-programmer в теле менеджера нет - в тело добавлен только класс
находки «код не в духе / переусложнён» с указанием «найди исполнителя сканом». И на
боевом прогоне по файлам менеджер сам, сканом по описанию находки, назвал обоих - и
code-reviewer, и dmitry-programmer. То есть динамическая диспетчеризация перестала
быть обещанием промпта: новый профильный ревьювер встроился в систему правкой своего
описания, а не правкой гейта. Это и есть механизм роста - набор профильных проверок
расширяется, а менеджер остаётся нетронутым.
Архитектурно это паттерн orchestrator-workers (центральный узел распознаёт задачу и раздаёт её специализированным исполнителям - «Building Effective Agents»), а специализация ролей и проверка промежуточных результатов «по ролям» формализованы в MetaGPT (Hong et al., 2023) через зашитые SOP. Моя поправка к ним - диспетчеризация по типу находки через живой скан штата, а не по зашитой схеме ролей: штат расширяется правкой описания нового инструмента, гейт не трогается.
4.3 Сессионный режим (dmitry-autopilot)
Скилл, который включает всё это на всю сессию и добавляет поверх оркестровку. Три уровня:
НАДЗОР (по явной просьбе) - голая дисциплина: исполнитель сам прогоняет работу через менеджера перед сдачей, оценивает планы до выполнения, доводит до ЧИСТО, не сваливается на меня раньше времени.
АВТОПИЛОТ (по умолчанию) - максимум автономии. Добавляет различитель масштаба: прежде чем спросить меня о чём угодно, развилка кладётся на одну из трёх полок:
- мелочь / рутина / дешёвый откат / ясный ответ → реши и сделай сам, не спрашивай и даже не копи;
- тактическое с реальным выбором, но обратимое → суррогат мнения через движок, не я;
- крупная ставка / необратимое / истинно вкусовое / само видение → не решай, отложи в очередь для меня.
Этот различитель - выписанная вручную политика learning to defer (Mozannar & Sontag, ICML 2020): агент решает не только задачу, но и когда передать решение дорогому эксперту-человеку. Порог тут не выучен на данных, а взят из линз (обратимость × ставка × ясность).
УГЛУБЛЕНИЕ (по явной просьбе) - надстройка для автономной доработки проекта за пределы заявленной задачи. На каждом ЧИСТО менеджер по ценностному гейту (разрыв до заявленной цели проекта + выжатость комбинаторики) генерирует следующий осмысленный слой - и петля идёт, пока не дотянул до планки и не выжата комбинаторика.
Механизмы этого слоя стоит назвать отдельно:
- Batch вместо потока. Отложенное-крупное не несётся мне по одному - копится и подаётся пачкой на естественном чекпоинте. Пока копится - исполнитель двигает всё, что решаемо без меня. Меня не прерывают на каждый вопрос.
- Канал доставки: по умолчанию меня нет у экрана. Дефолт перевёрнут намеренно. За экраном я меньшую часть времени, и «напишу в сессию» означает «сообщение полежит до вечера», поэтому всё, что различитель пометил «на владельца», уходит через отдельного агента-связного в мессенджер: он доставляет уведомление или задаёт вопрос и ведёт короткий диалог до внятного ответа. Порог «нести владельцу» при этом тот же, меняется только канал. Мелочь, которую не понесли бы при мне у экрана, в телефон тем более не несут.
- Перехват встроенных ask-механизмов. У исполнителя есть
AskUserQuestionи подобные - прямой канал ко мне в обход всей защиты внимания. В этом режиме они перехватываются: выбор/мнение → сначала движок; «стоит ли вообще спрашивать» → сначала менеджер. Прямой ask - только для того, что движок/менеджер пометили незаменимым. - Веер вместо линейной правки. На открытой развилке (нейминг, текст, механика, подход к нетривиальному фиксу) исполнитель не полирует первый черновик серией правок, а генерит 3-5 заметно разных вариантов, отбирает один - и полирует только его. Опора - асимметрия генерации и проверки: распознать хорошее сильно легче, чем создать, и лучший из пяти набросков почти всегда сильнее пятой правки первого. Кто отбирает - по тем же полкам различителя: тактическое - движок вслепую (варианты передаются без указания, какой писал первым и какой милее, - судья не должен знать фаворита), вкус-идентичность - меню владельцу, «что зайдёт получателю» - роль-зеркало аудитории. Мелочь и закрытые задачи с одним правильным ответом веером не гоняются - там это церемония.
- Промежуточные гейты - фоном. Прогон менеджера не требует участия исполнителя, поэтому промежуточный гейт запускается фоновым субагентом: пока тот думает свои ~75 секунд, исполнитель делает независимое - другую задачу, подготовку следующего слоя. Нельзя только строить новое поверх непроверенного куска и отчитываться владельцу до вердикта. Финальный гейт перед отчётом и гейт плана остаются блокирующими.
- Мелочь - пачкой на один гейт. Стоимость прогона гейта фиксированная (спавн + чтение контекста + линзы), и платить её за каждую мелкую правку расточительно: мелочь-tier копится и сдаётся списком из 2-5 позиций, каждая со своим «что сделано + чем проверено», а вердикт приходит по каждой позиции отдельно. Крупное и необратимое в пачку не кладётся никогда.
- Удержание режима. Главная поломка автономных режимов: после того как ответил на одну эскалацию, агент скатывается в «теперь спрашиваю напрямую обо всём». Скилл явно лечит это: ответ на эскалацию = закрытие одного пункта, а не сигнал перейти на интерактив. Но одной прозой это не держится - в длинной сессии инструкция тонет вместе со своей же строчкой «само-проверяйся». Поэтому режим возит пульс менеджера (см. §4.2): исполнитель заявляет режим в каждом вызове, менеджер возвращает памятку правил эхом - и правила остаются в свежем хвосте контекста всю сессию.
- План файлом, а не в переписке. На крупном ходе план кладётся в файл, а гейту передаётся путь. Причина техническая и несущая: гейт спавнится свежим каждый раунд, поэтому план в теле вызова пересылался бы целиком раз за разом и терялся при сжатии контекста. Файл переживает и то и другое, а гейт читает артефакт, а не пересказ заинтересованной стороны.
- Кончающийся контекст - не выход. Отдельное правило против частой поломки: агент сворачивает работу, потому что видит убывающий счётчик окна, и подаёт это как решение («предлагаю продолжить в свежей сессии»). Такого выхода нет. Состояние выносится наружу - в план-файл, доску, коммит, - и работа продолжается тем же ходом. Останавливает вердикт, блокер или человек, но не длина сессии.
Поверх трёх уровней встали две ортогональные оси. Это другое измерение работы:
- Темп (турбо). Включается моей явной просьбой «быстро». Скорость берётся не из отключения проверок, а из параллели: финальный гейт уходит фоном и отчёт его не ждёт, профильные ревьюеры стартуют одновременно с ним, раундов не больше двух. Цена снятого блока названа прямо. Раз отчёт уходит раньше вердикта, исполнитель обязан сам проверить территорию - командой, прогоном, скриншотом. И есть красные линии, где турбо не действует вовсе: необратимое, секреты, всё, что уходит к людям помимо меня, и всё, чью территорию нечем проверить.
- Вид работы (креативный). На творческом проекте дивергенция нужна не только на границе «что делать дальше», но и внутри исполнения. В этом режиме у различителя масштаба появляется четвёртая полка: творческая развилка внутри проекта уходит не в движок выбора, а мечтателю, коротким броском.
Потолок углубления - ценность, а не время. Бесконечная доработка - это gold-plating
против моего же shipping > polishing, поэтому петля обрывается ценностным гейтом
(бэклог осмысленного конечен), а не «пока не надоест». Жёсткий лимит по токенам, если
нужен, - это конфиг (хук/бюджет), а не промпт.
4.4 Генератор-мечтатель (dmitry-dreamer) - дивергентная половина
Первые три слоя конвергентны: они сводят - движок к одному выбору, менеджер к ЧИСТО, профильные ревьюверы к «годно/нет». Сам разрез конвергентное/дивергентное - из психологии творчества (Guilford, 1950-е: конвергентное мышление сходится к одному ответу, дивергентное расходится в поле вариантов). Но у системы была дыра, которую §3 честно называл: генератор целей - «за человеком». Мечтатель закрывает половину этой дыры.
Что он делает. Получает «куда мне дальше / за что взяться» и раскладывает широкое поле «векторов-желания» - не выбор, а россыпь кандидатов, из которой владелец узнаёт своё. Принцип - recognition, not generation: машина не порождает желание с нуля (это невозможно - искры в логах нет), она сужает бесконечность до десятка осмысленных направлений, чтобы было из чего узнать. Выбор и искра - за владельцем (та же граница, что вкус и необратимое).
Характер взят из карты личности, а не выдуман - и это поучительная история. Первая
версия вышла сухим аналитиком (фазы, критик-таблицы, баллы) - потому что я собрал её
на конвергентной машине (divergent-thinker с враждебным критиком внутри) и судил
конвергентным гейтом. Владелец ждал «генератора, который мечтает», а получил стратега в
костюме. Тон нашёлся не подбором, а в том, как владелец сам описывает свой творческий
режим: генератор желаний, который не терпит критики над собой; самое живое - игровое,
дурашливое состояние, где идеи и рождаются. Мечтатель пересобран под этот режим: дурачится,
мечтает образами, накидывает дико - но в гравитации ценностей владельца.
Притяжения-почва. Звучит мудрёно - на деле просто: в промпт мечтателя я списком вписал,
что меня по жизни тянет, а что для меня мертво. Заземление двустороннее, но невидимое: мечты
сами тянутся к тому, что владельца притягивает (свобода, своё укоренённое место,
инженерно-осуществимое-скоро) и огибают мёртвое для него (найм-с-присвоением,
дежурство-у-пульта), не озвучивая ни баллов, ни названий ценностей. Почва держит ноги, он её не комментирует. Standalone -
заземление вшито в тело, а тяжёлый агент с полным корпусом личности в рабочей схеме почти не
нужен; семья dmitry-* - это лёгкие срезы того же корпуса, не зависимые от него.
Модельно мечтатель - единственный субагент, которому я оставляю топ-модель (у меня - Opus): все остальные проверяющие слои держат роль на Sonnet, но дивергенция - ровно то место, где широта и вкус топ-модели окупаются, а дешёвая модель сваливается в сухой список без искры.
Кто его зовёт - структурный пробел. Первые три слоя конвергентны, и ни один НЕ инициирует мечтание: менеджер по природе сводит, а не расходится. Нужна отдельная роль - переключатель, который даёт руль генератору, - а её в схеме не было, и мечтателя приходилось звать вручную. Пришлось добавить явно, тремя узлами:
- триггер-переключатель (в скилле; в коде назван «триггер-Защитник»): на развилках направления - главное, после ЧИСТО менеджера, когда задача закрыта и встаёт «что дальше по-крупному» - исполнитель даёт руль мечтателю сам, не через менеджера (тот бы задушил, см. §11);
- креативный модификатор - третья ось скилла (помимо автономии и углубления): на творческом проекте дивергенция нужна и ВНУТРИ исполнения. Мечтатель чередуется со сборщиком по ходу (намечтал дикое поле → выбрал → собрал), а в углублении подкидывает дивергентные слои наравне с конвергентными слоями менеджера;
- крючок само-вызова - сам мечтатель в конце оставляет исполнителю напоминание «свистни меня снова, когда упрёшься в направление», чтобы конвергентная система про него не забыла.
4.5 Слой само-обучения (lessons-loop)
Пятый слой был самым молодым: в первой версии статьи он честно шёл с пометкой «экспериментальный». За два месяца боевой работы он её снял - база выросла вчетверо, ступень доверия отработала на живом материале, а сама петля успела назвать собственные пределы. Здесь - сжатый разбор; целиком этому слою (формат урока, ступень доверия, три уровня recall, судья-библиотекарь) посвящена отдельная статья. Разбираю, потому что дыра, которую он закрывает, во всей конструкции самая обидная.
Дыра: система не помнит своих граблей. Менеджер ловит промах и оставляет ноту
🧭 ВОРКФЛОУ «на будущее» - но это будущее длиной в одну сессию. Кончилась сессия - нота
умерла вместе с ней. Коррекцию, которую я написал агенту вчера, назавтра он уже забыл, и я
пишу её снова. Аудит месяца назвал это прямо: те же грабли из сессии в сессию - потерянные
реплики владельца, недоиспользованный движок, ложное «чисто» там, где гейт уже обламывался
раньше. Петля обучения разомкнута: система учится внутри сессии и обнуляется на её
границе. Задача не «научить агента думать лучше» - задача замкнуть перенос урока между
сессиями.
Что это. Папка LESSONS/ в git проекта - обычные текстовые файлы, по одному на урок.
Урок - не лог работы, а эвристика: короткое правило + мишень-провал, который оно чинит
- адресат (кому из агентов) + триггеры (под какую задачу всплыть) + статус доверия. Всё
plain-text под git - значит человекочитаемо, диффается, переезжает с репозиторием и
откатывается одним
git revert, если система научилась не тому.
Как работает. Урок проходит ступень доверия candidate → active → retired. Родившись,
он падает в карантин (candidate): наблюдается, копит свидетельства, но поведение не
меняет. Это главный предохранитель против отравления памяти - сырое наблюдение не рулит
агентами, пока не заслужило. Повторился, помог, не навредил - судья повышает его в active,
там он попадает в лёгкий индекс и начинает всплывать по триггеру. Устарел или оказался
неверным - retired, но след в git остаётся. Читается эта память тремя уровнями, у каждого
свой размен надёжности на стоимость: лёгкий индекс active-уроков грузится всегда на
старте (промах тут дороже лёгкого индекса); тело урока подтягивается только по совпадению
триггера; кандидаты в горячий путь не лезут вовсе - агент лезет в них сам, когда упёрся в
проблему, и берёт как гипотезу, не как правило.
Судит и пишет уроки не менеджер и не исполнитель, а профильный агент - lessons-curator,
судья и библиотекарь петли. Он единственный, кто пишет в LESSONS/ (одна точка
ответственности за целостность), и вызывается точечно на гейте пачкой - ровно как
code-reviewer, а между вызовами спит, постоянного оверхеда не даёт. Менеджер сам урок не
судит: он его диспетчит - распознаёт «тут обобщаемый урок проекта» и указывает
исполнителю запустить судью, тем же сканом по типу находки, которым зовёт code-reviewer
на баги и dmitry-programmer на вкус (§4.2). А отдельный офлайн-проход - «сон» - изредка
курирует библиотеку: сливает дубли, чистит устаревшее, разрешает конфликты между уроками.
Никогда в горячем пути, всегда отдельным заходом - тот же приём, что between-session
consolidation у Claude Dreaming.
Откуда взялась живая база. Ждать, пока уроки накопятся сами, - месяцы. Поэтому базу
завели холодным стартом из истории: прогнали историю кузницы - её changelog’и, коммиты и
транскрипты сессий - через анализатор, вычленили провал-сигналы (коррекции + повторы одного
механизма в разных местах),
сгруппировали по механизму и прогнали через того же судью. Из полусотни сырых сигналов
родилась 21 первая запись; сейчас в этой базе 80 файлов (59 из них active) и под семьсот
зафиксированных срабатываний, а всего таких баз на машине двенадцать. Ход тот же, что и со
сбором линз (§3): не спрашивать себя «на чём я обжигался», а вычитать это из следов реальной
работы.
Чего от него жду. Если слой сработает - те же грабли перестанут повторяться из сессии
в сессию: менеджер будет помнить прошлые обломы, коррекции владельца переживут сессию, движок
перестанут забывать звать. И всё это - направленно вверх: карантин не пускает сырое в
поведение, git делает любую деградацию видимой и обратимой, лёгкий индекс не даёт памяти
раздуть контекст. А поскольку ядро (формат урока, гейты, LESSONS/) вендор-нейтрально, а
вся привязка к Claude Code вынесена в тонкий адаптер, петля переносится на другой движок
сменой адаптера, не ядра.
Главное, что этот слой выучил за два месяца - и это меняет не только его. Счётчики срабатываний показали класс уроков, который не лечится текстом ни при какой формулировке: правило записано, прочитано на старте хода, признано очевидным - и провал повторяется в том же ходе. У верхнего урока такой счётчик дошёл до 44. Лечение оказалось не в словах, а в форме: такому уроку нужен исполняемый гейт - команда, которая сверяет заявленное с территорией и возвращает ненулевой код. И стоять он должен у того, кто заявляет. Проверяющий постфактум приходит поздно: тот же урок вырос с 11 до 44 срабатываний уже при готовом инструменте, потому что инструмент звали после сдачи. Переключилось всё ровно тогда, когда проверку привязали к событию «перед сдачей». Отсюда и правки в самом гейте (§4.2), и общий принцип для всякого повторяющегося промаха.
Что есть и чего нет - честно. Работает: ядро с форматом урока, трёхуровневый recall, судья, холодный старт ретро-сбором, ступень доверия на живом материале, амортизация библиотеки. Не работает как регулярная операция: промоут устоявшегося урока в стабильное ядро. Не проверен: порт на другой движок. Открыт: признак-триггер уборки, который срабатывает слишком часто и превращается в фон. Риски у памяти агента известные и неприятные (отравление, тихий дрейф, самозакрепление плохого) - против каждого стоит свой предохранитель (карантин; «помог ли», а не только «повторился»; git-аудит), но выдержат ли они объём - покажет только бой.
4.6 Продюсер продукта (dmitry-producer) - продуктовый этаж над менеджером
Все пять слоёв выше отвечают на вопрос «как довести эту работу»: движок закрывает развилку, менеджер доводит задачу до ЧИСТО, мечтатель накидывает, куда пойти. Но есть вопрос на этаж выше, на который вся конвергентная машинерия молчит: а что вообще делать с продуктом дальше - большим ходом. Его закрывает продюсер.
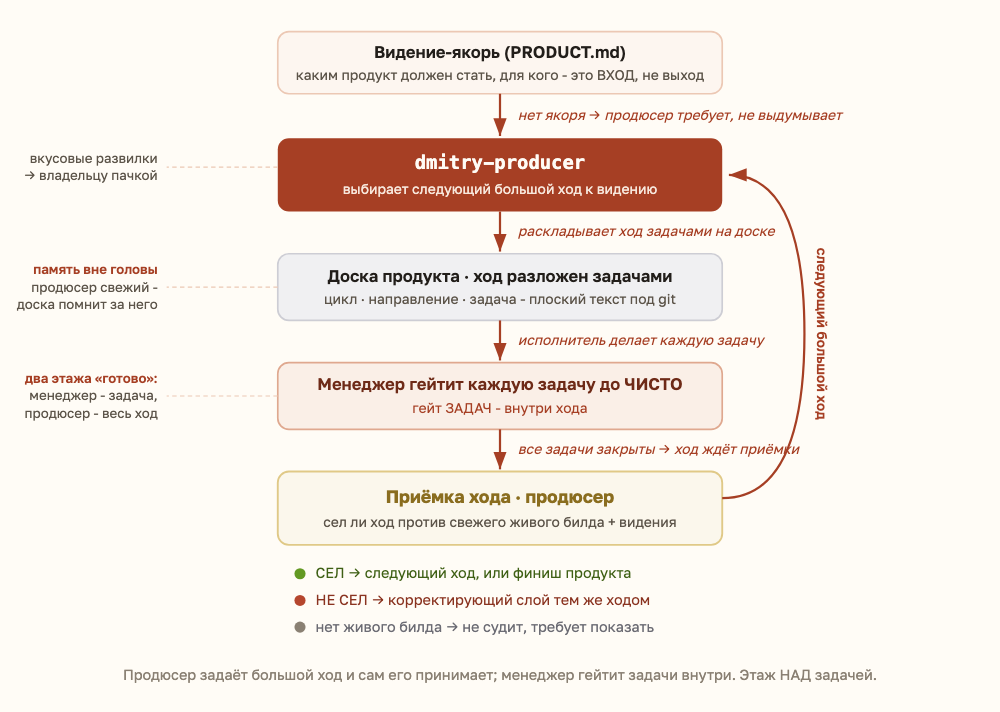
Рис. 3. Продуктовый цикл: продюсер задаёт большой ход к видению, менеджер гейтит задачи внутри хода, продюсер сам принимает ход по свежему живому билду - и петля идёт к следующему ходу. Память в доске переживает сессии, поэтому продюсер может проснуться и в остывший проект. Ср. Рис. 1 наверху: там маршрутизация одной развилки внутри сессии, здесь - этаж продукта над ней.
Зачем он - и это выведено из данных, а не из головы. Я прошёл по собственному кладбищу недоделанных проектов и увидел один и тот же провал, повторяющийся из продукта в продукт: сильный старт, а потом продукт умирает на MVP ровно тогда, когда моё внимание перескакивает на следующее интересное. Узкое место тут - не генерация направления (его как раз избыток: мечтатель, наоборот, переусердствует и уносит к очередному новому старту). Узкое место - удержание продукта в длинных циклах после того, как схлынул азарт. Значит нужный агент - не ещё один старт-генератор, а держатель циклов.
Что он делает. Продюсер выбирает следующий большой ход существующего продукта к его заявленному видению, раскладывает ход задачами на доске и возвращает исполнителю план. Как и менеджер, сам он ничего не делает и никого не спавнит (субагент не спавнит субагентов) - цикл крутит исполнитель, продюсер только советует и планирует. Он родственник менеджера, на этаж выше по объекту: менеджер отвечает «доделана ли задача», продюсер - «то ли мы вообще строим и куда дальше по продукту».
Память вынесена в доску - и переживает сессию. Продюсер - тонкий дирижёр: своей памяти в контексте у него почти нет, вся она снаружи, в доске задач продукта (плоские markdown-файлы: цикл, направление, задача) плюс тонкий якорь видения. В контекст он тянет компактный снапшот доски, а не историю - иначе много циклов в одной сессии утопили бы окно. И вот в чём ключ: доска - это то, что делает осмысленным автономное пробуждение. Продюсер спавнится свежим и не помнит прошлый раз - но доска помнит за него. Это тот же ход, что и в петле уроков (§4.5): вынести слой, который обычно живёт только в голове, в переносимый артефакт под версионированием, - только здесь это память о состоянии продукта, а не о граблях.
Видение - это вход, а не выход (несущая граница вкуса). Продуктовое видение - самый невоспроизводимый вкусовой слой, поэтому продюсер его не генерирует. Видение - его вход; нет якоря на входе - он его требует, а не выдумывает (узурпировать вкус владельца = выдать «правдоподобно, но не то», ровно мой анти-паттерн). Вкусовые развилки направления он копит владельцу пачкой, асинхронно, не блокируя цикл. Та же граница, что и везде: вкус и видение остаются за человеком, машина ведёт к заданному, а не назначает его.
Цикл и приёмка хода. Цепочка большого хода: продюсер задаёт ход → исполнитель делает его через исполнителей → менеджер гейтит каждую задачу до ЧИСТО → все задачи хода закрыты - но ход на этом ещё не закрыт. Продюсер делает приёмку хода: сел ли ход как целое по живому продукту и видению. Две петли разведены чисто: менеджер гейтит задачи внутри хода, продюсер владеет закрытием хода. Только приняв ход, продюсер даёт следующий - или ставит финиш. Развести их было не косметикой: пока приёмка была не за продюсером, исполнитель, закрыв задачи, уходил к менеджеру за «следующим слоем», а продуктовый ход оставался без того, кто судит его как целое.
Готовность судится глазами, не текстом доски. Этому научил боевой промах. Продюсер однажды
объявил ход «почти готовым», прочитав доску и вердикты проверяющих, - а живой продукт грубо
нарушал собственную определяющую идею; владелец увидел это мгновенно: «как ты не заметил». Отсюда
жёсткое правило: вердикт готовности выносится только по свежему живому билду, сверенному с
определяющей идеей. Нет живого взгляда - ❓, а не зелёный свет. Это ровно линза «карта против
территории» менеджера (§4.2), поднятая на этаж выше: территория продюсера - это продукт в работе, а
доска - лишь его карта.
Третий вход «что дальше». Продюсер закрывает пробел в карте слоёв. Теперь у системы три разных входа в вопрос «что дальше», и путать их - отдельный класс промаха:
- мечтатель (§4.4) открывает новую повестку - дивергентно, с нуля («за что вообще взяться»);
- менеджер-углубление (§4.3) достраивает слои текущей задачи - конвергентно, на этаже задачи;
- продюсер выбирает следующий большой ход продукта к видению - конвергентно, на этаже продукта.
Один и тот же вопрос, три высоты. Мечтатель питает продюсера новым направлением, но не заменяет его; продюсер конвергирует и ведёт цикл, но не рождает продукт с нуля.
Третья ось гейта - накопленный продуктовый долг. Первые две оси у продюсера очевидные: есть ли разрыв до заявленного видения и выжата ли комбинаторика уже существующего. Третью пришлось добавить, когда стало видно: в базе уроков проекта копятся записи про сам продукт - рецидивящие, подтверждённые, про фичу, а не про процесс, - и никто их наверх не поднимает. Теперь продюсер сам вычитывает их и выносит владельцу отдельной развилкой. Память проекта работает уже не только на агентов.
И одна правка, которая стоила дороже всех остальных. В тело продюсера пришлось вписать именованный запрет на разрушающие команды - удаление, перемещение, откат, перезапись. Повод был буквальный: агент, «прибираясь от временных скриншотов», снёс по маске два десятка неотслеживаемых файлов в рабочей папке - безвозвратно. Урок здесь про два свойства класса, а не про конкретную команду. Первое: описание роли («это продуктовый советник, файловые операции не его дело») такой промах не держит - это контекст, не запрет. Второе: самопроверка структурно слепа к своему ущербу - состояние репозитория после удаления неотслеживаемых файлов выглядит чище, чем до, поэтому «я всё проверил» здесь искренне и бесполезно.
Модельно продюсер, как и менеджер, - на Sonnet, не на топ-модели: вкус он не решает (копит владельцу), поэтому суждение у него методологическое, а не глубоко-вкусовое, и дешёвая модель его держит.
4.7 Штабной этаж: пульт и представитель штаба
Шестой слой отвечал на вопрос «что дальше по продукту». Седьмой появился из вопроса, который раньше просто не возникал: что делать с находкой, которая не влезает в текущую работу.
Ситуация типовая до скуки. Агент чинит одно и по дороге видит другое - баг в соседней области, чужую поломку, крупную доработку на неделю. Вариантов у него раньше было два, и оба плохие. Полезть чинить: задача расползается, ход перестаёт быть проверяемым. Или написать в отчёт строчку «а ещё я заметил» - она умирает вместе с сессией. Я наблюдал это сотнями.
Помогло не правило, а адресат. Появился отдельный агент - представитель штаба, - которому находка передаётся как есть, и он решает, чем её двинуть: завести отдельный заход под неё, дописать реплику в уже идущую работу (там контекст ещё тёплый - часто это верная дверь), положить предложение в очередь моих согласий или отказать с причиной. Работу он не делает и качество её не судит. Он маршрутизирует, по уставу, который читает с диска.
Под ним стоит вторая половина этажа - локальный пульт: веб-панель над всеми проектами машины, в которую я заглядываю с телефона. Что где происходит прямо сейчас, состояние задач и репозиториев, расход токенов, очередь предложений, ждущих моего «да». Смысл её тут один: автономная система хороша ровно настолько, насколько до неё дотягивается человек, - а пока единственный канал к ней терминал на рабочем столе, автономность упирается в моё присутствие за столом.
5. Поток одной развилки end-to-end
Чтобы слои сложились в голове, вот путь, который проходит типичная развилка в режиме автопилота (в этом потоке участвуют несущие три - различитель, движок, менеджер):
- Исполнитель упёрся в выбор. Различитель масштаба (слой скилла) кладёт его на полку.
- Мелочь (переименовать локальную переменную, обратимо, ясно) → решает сам, идёт дальше. Меня нет в петле, движка тоже.
- Тактическое обратимое (какой из двух подходов к парсингу) → зовёт движок,
получает
Я бы [B]. АЛГОРИТМ: трудозатраты × выхлоп - A сложнее без выигрыша.Закрыто на дешёвой модели. - Работа доведена до «вроде готово». Прежде чем сказать мне «готово» - исполнитель зовёт менеджера, стадия ГОТОВО, передаёт замысел + что сделал + токен сессии.
- Менеджер судит свежим взглядом по линзам → читает ledger → находит, что в прошлом
раунде была флагнута правка в соседнем модуле, которая тихо не доехала →
🔧 ДОДЕЛАТЬ: правка из раунда 2 не закрыта (линза 5: полнота). + 🛠️ ЗАПУСТИТЬ code-reviewer на затронутую логику - объём вне моих линз (линза 8). - Исполнитель доделывает, запускает code-reviewer, зовёт менеджера снова (раунд N+1) - промежуточные раунды можно гонять фоном: пока гейт думает, исполнитель двигает независимое.
- Менеджер:
✅ ЧИСТО (линзы 1,2,3,5,8). К владельцу не идёт, действуй.- и попутно🧭 ВОРКФЛОУ: второй раз приносишь без прогона ядра вживую - прогоняй до "готово". - Только теперь исполнитель отчитывается мне - по сути результата, не «подтверди». А три вкусовых развилки, всплывших по дороге, ждут меня пачкой на этом же чекпоинте.
Я в этой картине касаюсь работы один раз - на пачке вкусового в конце. Всё остальное - между исполнителем, движком и менеджером.
6. Почему это дёшево
«Дёшево» здесь - не только про токены, а про четыре разных ресурса:
- Внимание человека (самый дорогой) тратится только на необратимое и вкусовое, и только пачкой. Различитель масштаба + batch + перехват ask втроём отсекают весь поток мелких вопросов.
- Контекст. Менеджер и движок - субагенты в чистом окне. Они не пачкают контекст главной сессии своими рассуждениями: исполнитель получает обратно только компактный вердикт-инструкцию, а не простыню. Чистое окно у менеджера - ещё и условие его независимости (он судит срез, а не варится в той же каше, что исполнитель).
- Модели по слою. Каждый слой можно спустить до минимальной модели, которая ещё держит его роль - и эта планка оказалась куда ниже, чем кажется (замеры - в следующем разделе): роль движков и плейтестеров тянет DeepSeek v4-flash, менеджера - v4-pro, и оба воспроизводят Sonnet-уровень (в ежедневной работе я сейчас держу проверяющие слои на Sonnet - я на подписке Claude Code). Никто не платит за топ-модель там, где обвязка вытягивает дешёвую.
- Токены цикла. Анти-застой обрывает бесконечные петли на 2-3 раунде, ценностный гейт останавливает углубление. Бесконечная доработка структурно невозможна.
Вместе они и складываются в то самое «очень эффективно и дёшево»: дорогие ресурсы под жёсткой защитой, дешёвые - расходный материал.
7. Модельная экономика: каждый слой спускается по лестнице моделей
Всё выше объясняет, почему система дешёвая структурно. Но был и прямой эмпирический
вопрос: на какой минимальной модели каждый слой ещё держит свою роль? Чтобы ответить не
догадкой, я построил стенд - маленький CLI-фронт, который гоняет один и тот
же кернел агента через разные бэкенды и модели (opencode с тулами, чистый text→text
через llm, и т.д.) и сверяет результат с эталоном на Claude. Это превратило «потянет
ли дешёвая модель» из веры в замер.
Сначала - урок метода, без которого все цифры ниже были бы ложью. Первый вывод
стенда звучал как «DeepSeek роль не держит, нужен Claude». Территория (трейс прогона) его
опровергла: слом роли был не природой модели, а дырой в обвязке - у агента,
запущенного через opencode, оставались открыты встроенные тулы skill/task, и
плейтестер втихую подгружал чужую методологию вместо отыгрыша игрока. Закрыл тулы
правильно - и flash, и pro держат роль нормально. Вывод в рамку: прежде чем списать
провал на «слабую модель», проверь обвязку - чаще виновата она.
Что в итоге село на какой слой (всё замерено в сравнении с Sonnet-эталоном на стенде):
- Движки выбора (
dmitry-choice-engine,dmitry-engine) → DeepSeek v4-flash, чистый text→text, тулы выключены. На калибровочном наборе кейсов в сравнении с Sonnet: верный выбор 5/5 на базовых кейсах, 4/5 на сложных - и оставшийся промах кернельный (конфликт двух правил в самом промпте), его не лечит ни pro, ни thinking-режим. 3-4 секунды на кейс. Отдельная находка: thinking-режим движку не нужен - он применяет правила, а не рассуждает; thinking выходил в 5-10 раз медленнее без выигрыша. Тёплый прогон ≈ $0.0003. - Плейтестеры-роли (25 срезов аудитории) → DeepSeek v4-flash, тулы выключены. flash отыгрывает роль на уровне Sonnet-эталона - ловит те же красные флаги, реагирует как игрок, держит формат-сводку. pro - тоже блестяще, но ~2× медленнее без прибавки. Для чистого отыгрыша роли flash достаточно.
- Менеджер (
dmitry-manager- сложный протокол + реальные тулы) → **DeepSeek v4-pro- opencode** (per-tool гейт; критик без write/edit). Боевой прогон на фикстуре
«заявлено ≠ в файле»: pro прочитал файл, вызвал аудиторскую память, соблюл жёсткий
порядок «суждение → память → сверка», поймал карту-против-территории (нет валидации,
фабрикация прогона), выдал
🔧 ДОДЕЛАТЬс привязкой к линзам +🧭 ВОРКФЛОУ+ директиву цикла - и не штампанул✅. Воспроизвёл методологию с реальным использованием инструментов. Тот же протокол на Claude Sonnet выходит идентичным - pro на менеджере ≈ Sonnet-уровень.
- opencode** (per-tool гейт; критик без write/edit). Боевой прогон на фикстуре
«заявлено ≠ в файле»: pro прочитал файл, вызвал аудиторскую память, соблюл жёсткий
порядок «суждение → память → сверка», поймал карту-против-территории (нет валидации,
фабрикация прогона), выдал
- Профильный ревьювер вкуса (
dmitry-programmer- read-only кодекс из 8 линз) → как нативный субагент Claude Code он на Sonnet, а его дешёвая альтернатива - тот же класс, что у менеджера: DeepSeek v4-pro + opencode (реальные тулы, без write/edit). Real-agent eval на стенде (настоящий backend, не прокси): 6/6 нетривиальных кейсов PASS - поймал оверинж, не-в-духе и AI-наросты по кодексу, не путая их с багами (баг он лишь помечает как[БАГО-РИСК]- наводку дляcode-reviewer). Лишнее подтверждение, что граница flash/pro идёт по сложности протокола, а не по вендору: судить вкус кода целым кодексом - это снова pro-класс, и v4-pro воспроизводит на нём Sonnet - то есть служит дешёвой заменой Claude-субагенту, как и на менеджере.
Где проходит граница flash/pro. Не между «дешёвым DeepSeek» и «дорогим Claude», а внутри DeepSeek: чем сложнее протокол агента, тем выше нужна модель. flash отлично применяет правила и отыгрывает роль, но многошаговый протокол менеджера не держит (сваливается в голый вердикт без линз и цикла). pro держит - и держит так же, как Sonnet. То есть лестница здесь flash → pro, а топ-Claude как обязательное условие из неё выпадает вообще.
Канал и цена - и здесь за два месяца сменилась вся картина. Потокенная оплата ушла на второй план. Основной канал к дешёвым моделям теперь подписочный, с фиксированной месячной платой и квотой на объём генерации, и разница тут не только в деньгах: квоту жжёт генерация, а не размер контекста. Это меняет тактику. Замер на четырёх десятках запросов: вызов с огромным контекстом и коротким ответом стоит вчетверо-впятеро дешевле вызова с маленьким контекстом и длинным ответом. То есть большой контекст агенту можно скармливать без опаски, а следить надо за длиной его ответа - наперекор интуиции, выросшей на потокенной оплате.
Практический вывод: прогонять роли на дешёвых моделях стало ещё выгоднее, чем на момент первой версии этой статьи. Тёплый прогон движка или плейтестера по-прежнему стоит доли цента, а на подписочном канале - фактически ничего сверх абонентской платы.
Сводный посыл слоя. Чуть доработать промпты под DeepSeek v4 - правильно закрыть встроенные тулы и развести склеенные в кернеле правила, - и важные субагенты выходят на уровень Sonnet. Граница качества проходит не по модели, а по обвязке.
Что я гоняю на самом деле. В ежедневной работе я на подписке Claude Code: исполнитель - Opus 5, проверяющие субагенты - Sonnet 5, мечтатель - Opus. Живой расход по дням - от полутора до трёх миллионов токенов, и 85-97% из них съедает исполнитель. Проверяющий слой на фоне исполняющего почти бесплатен - сам по себе аргумент в пользу «проверять много и часто».
Параллельно вся семья ролей зеркалится во второй агентный рантайм и работает там на дешёвых подписочных моделях. Это не запасной аэродром на бумаге, а живой второй путь: часть ролей я регулярно гоняю там, и они держат уровень. Из практики переноса вышло отдельное правило, которое дороже самой экономии: чужому рантайму отдают генерируемую копию, а не ссылку на исходник. Агентная среда с правами на запись однажды «починила» то, что сочла сломанным конфигом, - и правка ушла по символической ссылке прямо в отслеживаемый исходник моей мастерской. Нашлось это только по состоянию репозитория.
А вот здесь первая версия статьи была неправа - и это стоит показать целиком, потому что методология тут важнее вывода. Я писал, что модели OpenAI роль, скорее всего, не удержат: у них сильная дефолтная персона, и они сваливаются в неё из любой назначенной роли; территорию я честно помечал непроверенной. Потом я её проверил. Двадцать прогонов, пять конфигураций на четырёх сценариях, слепое судейство: 20 из 20 по качеству, роль держится, а по скорости модель ещё и обошла дешёвую альтернативу вдвое-втрое. Прежний скепсис был правдоподобной гипотезой из чужого опыта. В замере он не подтвердился.
Оставляю этот абзац в статье намеренно, вместе с опровержением. Он показывает ровно то, ради чего вся конструкция и строилась: гипотеза - это кандидат, а не факт, и разница между ними - прогон. Правило «не вини модель раньше обвязки» тут сработало ещё раз, только в неожиданную сторону: виновата была не обвязка и не модель, а непроверенное убеждение.
Если качество - в обвязке, то и исполнителя можно удешевить
Исполнитель (главная сессия) у меня сейчас на топовой модели. Но логика всей системы предсказывает, что это не обязательное условие - и более того, что выигрыш от обвязки тем больше, чем слабее исполнитель.
Менеджер-гейт, движок-суррогат, линзы и цикл - это экзоскелет, который ловит ровно тот класс ошибок, что слабая модель делает чаще: не тот объект, недоведённая полнота, «готово» без прогона, лишняя абстракция. Сильный Opus делает их реже - поэтому прирост от обвязки на нём как раз наименьший. Слабый исполнитель под той же обвязкой должен показывать себя увереннее, чем в одиночку, потому что система компенсирует именно его слабые места: каждую типовую ошибку перехватывает своя линза, и цикл не выпускает работу, пока она не закрыта.
Это и есть главное экономическое следствие архитектуры: обвязка переносит качество с модели на процесс. А значит удешевлять можно не только проверяющие слои (это уже замерено - flash/pro вместо Sonnet), но и сам исполняющий - спускать его по лестнице моделей, опираясь на то, что экзоскелет вытянет.
Честная пометка про территорию: первое - замерено (движки, плейтестеры, менеджер на DeepSeek против Sonnet-эталона на стенде). Второе - про слабого исполнителя под обвязкой - пока предсказание из логики системы, не замер: исполнителя на дешёвой модели я системно не прогонял. Гипотеза сильная и проверяемая, но это следующий эксперимент, а не готовый результат.
Потолок качества: фронтир-результат без фронтир-модели
И отсюда - вывод, который на практике важнее экономии. Такой обвязке не нужна топовая фронтир-модель, чтобы давать топовый результат. Когда самая сильная на тот момент закрытая модель была ещё доступна, я сравнивал её напрямую с моей связкой (топовая модель на исполнителе
- субагенты на средней): по качеству выхода - кода и решений - разницы почти не было, только по скорости (связка медленнее, потому что прогоняет несколько проходов проверки вместо одного ответа). А по деньгам связка выходила даже дешевле. То есть мульти-агентная система делает ровно то, ради чего тянутся к закрытым фронтир-моделям, - очень качественный результат на выходе, - просто берёт его не одной огромной моделью за один проход, а связкой моделей поменьше под взаимной проверкой. Медленнее - но доступно, воспроизводимо и дешевле.
Обвязка делает в рантайме то, что фронтир печёт в веса
Почему дешёвая модель под обвязкой вообще догоняет топовую - видно, если посмотреть, из чего складывается качество самих фронтир-моделей. Приёмы, в общем-то, те же.
Лаборатории растят качество на обучении через внешнюю проверку: модели-верификаторы отбраковывают решения (Cobbe et al., 2021), process-reward модели награждают верные промежуточные шаги, а не только финал (Lightman et al., «Let’s Verify Step by Step», 2023). Менеджер-гейт с линзами - та же конструкция, только проверка происходит не на обучении, а на каждой задаче, и награда - не градиент, а вердикт «доделать». А ПЛАН-гейт - это process reward в чистом виде: поймать неверный шаг до того, как в него вложена работа.
Второй столп фронтира - test-time compute: дать модели думать дольше до ответа окупается лучше, чем растить саму модель (Snell et al., 2024); внутри thinking-режимов она черновик критикует и переписывает до выдачи. Петля раундов - тот же механизм, растянутый во времени: слабая модель плюс несколько дешёвых итераций с внешним судьёй приближается к сильной за один проход. Условие одно, и оно несущее: судья должен быть надёжным - иначе итерации крутят мусор по кругу.
Третий - best-of-N и rejection sampling: сгенерировать много, отобрать лучшее. В обвязке это веер (§4.3), и держится он на асимметрии генерации и проверки: слабая модель редко пишет отличный вариант с первой попытки, но среди пяти её разных попыток один отличный есть почти всегда - и распознать его способен даже слабый судья. «Сделай гениально» модель не может; «сделай много и выбери» - может.
Четвёртый - verifiable rewards: фронтир тренируют на задачах с машинно-проверяемым исходом (тесты, компилятор), где нельзя наградить правдоподобие. В обвязке это проверяемое определение готовности, названное до старта (§4.2): хуже всего у слабой модели именно самооценка - она искренне считает сырое готовым, - и заранее заданная внешняя мишень отбирает у неё право судить себя ощущением.
Сложить вместе - и получается формула, на которой весь этот раздел стоит: слабый генератор + узкая роль с полным контекстом + дистиллированная рубрика + внешняя проверяемая проверка + итерация и отбор = работа на класс-два выше веса модели.
Из этой же рамки видно и будущее обвязки. У неё две половины. Половина-компенсатор - дисциплина проверки, ловля сырости, вечное «а прогнал ли ты» - обесценивается с каждым поколением моделей: ровно её фронтир и забирает внутрь, и раунды до «чисто» будут сокращаться сами. А половина-информация - кернел с моими линзами, корпуса реальной аудитории у ролей-срезов, независимый свежий взгляд в чистом окне, внешняя аудиторская память, маршрутизация моего внимания - не обесценивается вообще: этого в модели нет и не будет, потому что это не про способности модели, а про меня и мой контекст. Чем автономнее становятся агенты, тем дороже именно эта половина - то, что превращает безличного агента в моего.
8. Почему ничего не забывается и всё проверено
Это вторая половина опыта - «точно покрывается, ничего не забывается». Складывается из семи независимых механизмов, каждый закрывает свой класс утечки:
- Карта против территории (линза 2) - «готово» не принимается на веру. Подписывается
только проверка, тождественная цели; совпадение удобного коррелята =
assumed, неverified. Уверенный тон агента - повод усилить скепсис, а не расслабиться. - Полнота (линза 5) - сделано во всех местах, не наполовину. Прямой наследник моей самой частой проверки «во всех языках почистил? везде обновил?».
- Достаточность ревью (линза 8) - мета-линза, проактивно тянет недостающий проход (code-reviewer на объём, живой прогон ядра, недостающий тест) даже когда своих находок нет. Отсутствие находок ≠ ЧИСТО, если работу нельзя подписать без прохода, который не сделан.
- Экстернализация контекста (линза 10) - «зачем/как» уходит во внешний носитель (таск, коммит, план), а не висит в памяти, которая на длинном горизонте забудет.
- Аудиторский ledger с двойной записью - независимый след менеджера ловит между раундами то, что исчезает из одного среза: брошенные правки, регрессии, повтор паттернов, дубли раундов. Суждение до чтения памяти - чтобы память не отравила свежесть.
- Реестр живых указаний - директивы владельца, брошенные по ходу сессии, оседают в явном списке и передаются гейту вместе с задачей; «я же выше просил» ловится сверкой с реестром, а не надеждой на память.
- Пульс протокола - правила самого режима не тонут в длинной сессии: менеджер возвращает их короткой памяткой в конце каждого ответа, и они всегда в свежем хвосте контекста исполнителя.
И поверх всего - цикл до ЧИСТО: исполнитель не имеет права остановиться на «вроде
ок». Выходов из цикла ровно три (✅ ЧИСТО, ⚠️ НА ВЛАДЕЛЬЦА, ❓ НЕ ХВАТАЕТ КОНТЕКСТА),
и первый из них означает, что прогон по линзам реально закрыт.
9. Приёмы, которые стоит забрать себе
Если переносить чьи-то принципы вы не планируете, а просто хотите более надёжного автономного агента под продукт - вот переносимые узлы:
- Разделите «суррогат мнения» и «гейт качества» на два агента. Дешёвый узкий движок для тактических развилок (один выбор + причина, и замолчать) снимает нагрузку с дорогого менеджера и с человека.
- Гейт советует, исполнитель делает - и гейт держит цикл само-напоминанием. Stateless-субагент не возобновляется сам и не запускает следующий шаг, поэтому он ничего не делает и не спавнит - он указывает (доделай то, запусти такой-то инструмент, позови суррогат мнения вместо человека) и каждый ответ завершает требованием вызвать его снова ровно по имени, пока не выдаст «чисто». Так петлю крутит исполнитель, а условие выхода держит гейт. Без точного самоназвания исполнитель на следующем круге подменит гейт «каким-нибудь ревьювером» и потеряет его линзы и память.
- Вердикт-как-замена-подтверждения, не как дополнение. Если «чисто» от гейта всё равно несут человеку «на всякий случай» - гейт бесполезен. Пропишите явно: одобренное гейтом не идёт наверх.
- Ролевая независимость гейта. Исполнитель - заинтересованная сторона; гейт не подчиняется его директивам «проверь только X / скажи ок». Давление = сигнал усилить внимание. Без этого самопроверка автором слепнет к своим огрехам.
- Различитель масштаба на полки. Три базовых (сам / суррогат / человек) по осям обратимость × ставка × ясность - простейший и самый окупаемый механизм против дёрганья по мелочи. В креативном режиме добавляется четвёртая: творческая развилка внутри проекта → генератор-мечтатель (дивергенция, а не суррогат-выбор).
- Batch вместо потока. Накапливать развилки для человека и подавать пачкой на чекпоинте, а не прерывать на каждой.
- Перехватывайте встроенные ask-механизмы.
AskUserQuestion- это чёрный ход в обход всей вашей защиты внимания. В автономном режиме его надо явно перехватывать. - Карта против территории как явная линза. Заставьте гейт различать
verified(сверено с целью) иassumed(совпала удобная карта). Это лечит главную ложь автономных агентов - «готово», которое скомпилировалось. - Двойная запись с суждением до памяти. Независимый аудиторский след ловит брошенные правки и регрессии между раундами - но читать его надо после того, как сформировал свежее суждение, иначе он отравит независимость.
- Правьте процесс, а не только артефакт. Отдельный канал «ноты по способу работы» (не по куску) за несколько итераций прививает привычку - агент сам начинает приносить проверку и прочтение замысла.
- Останавливайте автономную доработку по ценности, а не по времени. Ценностный гейт («есть ли разрыв до заявленной цели + выжата ли комбинаторика») сам останавливает петлю на gold-plating; жёсткий лимит - это конфиг, не промпт.
- Диспетчеризуйте по типу находки и динамической карте инфраструктуры, а не по
зашитым именам - новый инструмент в штате подхватывается без правки гейта. У меня
это подтвердилось буквально: добавил профильного ревьювера вкуса кода
(
dmitry-programmer), не тронул менеджера - и менеджер сам назвал его сканом по описанию находки, рядом сcode-reviewer. Растите систему правкой описаний новых инструментов, а не тела гейта. - Разделяйте дивергенцию и конвергенцию на разные агенты. Генератор поля (расходится, не выбирает) и гейт качества (сводит к готовому) - противоположные функции; в одном агенте критик задушит генератора. Это общий закон творческих процессов: роли генератора и критика надо разводить, иначе критик рубит идеи на взлёте.
- Не судите роль её структурным антагонистом. Конвергентный гейт хорош на конвергентной работе, но искажён как судья дивергента (тянет к дисциплине, к «не-плоди»). Дух дивергентного агента утверждает человек + нейтральный слепой судья, не критик-гейт.
recognition, not generationдля целей. Генератор повестки не выдаёт «твою цель» - он раскладывает поле кандидатов, из которого человек узнаёт своё. Искру оставьте человеку: это и выполнимо (поле выносимо), и честно (само желание - нет).- Заведите отдельную роль «кто инициирует дивергенцию». Конвергентные роли сами не позовут генератора - это против их природы. Нужен явный триггер-переключатель, иначе система всегда сходится и расхождение просто не случается.
- Веер вместо полировки первого черновика. На открытой развилке - N заметно разных вариантов, слепой отбор, полировка только выбранного. Судье варианты передавайте без указания фаворита. Опора - асимметрия: распознать хорошее легче, чем создать.
- Проверяемое «готово» - до старта. План не годен, пока не названы проверки (тест / команда / прогон / скриншот), по которым работа будет считаться сделанной. Это отбирает у агента право судить себя ощущением «вроде норм».
- Гейт - фоном, мелочь - пачкой. Стоимость прогона гейта фиксированная: платите её реже (2-5 мелких позиций одним вызовом, вердикт по каждой) и параллельно (промежуточный гейт фоновым субагентом, пока исполнитель двигает независимое). Финальный гейт перед человеком - всегда блокирующий.
- Возвращайте правила через самый частый канал. Любая инструкция тонет в длинной сессии. Найдите канал, который срабатывает часто и не забывает (у меня - свежеспавнутый гейт), и заставьте его возвращать короткую памятку правил в каждый ответ - условно, только когда вызывающий заявил режим.
- Разведите «задача готова» и «продуктовый ход сел» - это два разных этажа готовности. Гейт задачи (доделано ли) и приёмка большого хода (сел ли он по живому продукту и видению) - разные объекты; второй судит не гейт задач, а роль на этаж выше. И вынесите память этого продуктового слоя в версионируемую доску, а не в контекст: тогда stateless-агент может вести длинные циклы и даже просыпаться в остывший проект - доска помнит за него. Видение при этом - вход роли, не выход: оркестратор ведёт к заданному, но не назначает его сам.
- Повторяющийся промах лечите формой, а не формулировкой. Если правило записано, прочитано и всё равно нарушается - дело не в словах. Ставьте под него команду, которая сверяет заявленное с фактическим и падает при расхождении, - и ставьте её у того, кто заявляет, привязанной к событию (перед сдачей, перед фиксацией). Проверка у проверяющего постфактум приходит туда, где смотреть уже нечего.
- Церемонию регулируйте масштабом задачи. Одна шкала - число единиц работы - и три уровня: точечная правка, многошаговая задача, многозадачный ход. Масштаб снимает ритуал, но не проверку: мелочь копится и сдаётся пачкой, а не проскакивает мимо гейта.
- Скорость берите из параллели, а не из отключения проверок. Гейт фоном, профильные проходы одновременно, потолок в два раунда - и обязательная плата за снятый блок: раз отчёт уходит раньше вердикта, автор сам проверяет территорию командой или прогоном. И назовите красные линии, где режим скорости не действует: необратимое, секреты, всё, что уходит наружу.
- Дайте находке, не влезающей в текущую работу, отдельный адрес. Иначе у агента остаётся выбор из двух плохих: расползтись на чужую задачу или похоронить наблюдение в отчёте. Адрес может быть простым - очередь, доска, отдельная роль-маршрутизатор, - но он должен быть.
10. Границы и честные оговорки
- Вкус и видение не кодируются - и не должны. Система намеренно их распознаёт и откладывает, а не решает. Финальный фильтр на необратимом и вкусовом остаётся за человеком. Кто попробует засунуть в движок ещё и «чего я хочу» - упрётся в то, что генератора целей в логах почти нет. Поправка по итогам: выносимо не само желание, а ПОЛЕ кандидатов (это делает мечтатель, §4.4) - но финальная искра, «загорелся именно этим», неотчуждаема и осталась за человеком.
- Это поведенческая подпись конкретного человека - и её качество решает всё. Линзы, hard-constraints и якорные кейсы - мои. Чтобы перенять архитектуру под себя, придётся собрать свой revealed behavior (свои реплики-коррекции - самое ценное сырьё) и выписать свои линзы. Чужой кернел даст чужие решения - и это не нейтрально: скопируете принципы у того, кто в предметной области не разбирается, - и агент будет уверенно выдавать хреновый результат, garbage in - garbage out. Кернел - не магия модели, а данные и их анализ; именно они позволяют выжимать из модели максимум. Поэтому архитектуру я выкладываю (эта статья, §9), а содержимое кернелов - нет: в нём и есть главная ценность системы. Но даже если бы я их выложил, эти агенты решали бы как я, а не как вы, - и вам, скорее всего, не подошли бы.
- А что делать, если своих сильных принципов пока нет? Честный ответ - наработать их, и быстрой кнопки тут нет. Стартовать можно с чужого хорошего каркаса: списать принципы у известных личностей, у философских школ, у внятных инженерных и архитектурных подходов - и дальше набирать свои данные и практику, прогоняя каждый принцип тем же тестом «выбрал бы так я». Заёмный каркас - это леса на старте, а не готовый кернел: своим он становится только через свой revealed behavior, иначе агент уверенно отыгрывает не вас.
- Проценты в методологии - эвристические, ±. Это ручная классификация, не доказанная статистика. Качественные паттерны надёжнее цифр.
- Гейт хорош ровно настолько, насколько у него есть чем проверить. Когда линзу
нечем закрыть (нет доступа к реальному артефакту), честный ответ -
НЕ ПРОВЕРЕНО, а не зелёный свет. Система спроектирована это признавать, но это её потолок: она не заменяет проверку, которую физически нельзя выполнить. Месяц транскриптов показал этот потолок предметно: редкие ложные «чисто» случались ровно там, где территория гейту недоступна, - живой рендер в браузере, мобильный тач, внешние факты. Отсюда жёсткое правило для визуальных артефактов: без живого прогона и скриншота территории «готово» гейту не заявляется вовсе. - Защита внимания не абсолютна - и это измерено. На месячном срезе примерно четверть вопросов, дошедших до меня, были тактическими - их мог бы закрыть движок. Протечку душат перехват ask и пульс протокола, но в ноль она не сходится: различитель - это внимание модели, а внимание в длинной сессии дырявое. Радикальное лечение - вынести правила в хуки раннера, структурно; пока обхожусь дешёвыми слоями.
- Менеджер - субагент, и не спавнит субагентов. Запуск инструментов держит исполнитель. Если ваш раннер так не умеет - этот узел придётся перестроить.
11. Дивергенция и роли-режимы
Пока система была только конвергентной (проверять, сводить, доводить), её удобно было описывать как «операционку решений». Но как только я добавил дивергентный слой - генератор, который не сводит, а расходится, - стало видно то, чего я не закладывал нарочно: система разложилась на несколько функциональных ролей, и у этих ролей есть внутренний конфликт.
На пальцах, без философии: это как редактор и автор. Чтобы писать, автору надо накидывать свободно, не оглядываясь; работа редактора - резать и сомневаться. Посади редактора за плечо автору, пока тот сочиняет, - и автор зажмётся. Ровно это у меня и вышло, только «редактор» и «автор» - не люди, а два промпта с противоположными задачами: менеджер заточен резать и сводить, мечтатель - расходиться. Чем их столкновение кончилось и как чинилось - разбираю ниже. Никакой мистики: просто два текста-инструкции тянут в разные стороны.
Параллели этому давно описаны - и стоит назвать их прямо. Триада «генератор-реалист-критик»
- это метод Уолта Диснея (Dreamer / Realist / Critic), смоделированный Робертом Дилтсом (1994): Дисней буквально разносил три роли по разным комнатам, чтобы критик не задушил мечтателя - один в один моя проблема ниже. «Множественное я» - линия от «Общества разума» Минского (1986) до его прямого ИИ-эха - мульти-агентного спора (Du et al., «Improving Factuality… through Multiagent Debate», ICML 2024), где несколько экземпляров модели играют разные роли. Но для инженерных целей достаточно функциональной рамки: кто сводит, кто расходится, кто переключает.
Роли. Слои ложатся на них почти один к одному:
| Роль | Агент | Делает |
|---|---|---|
| Сборщик | исполнитель (главная сессия) | собирает, держит поток |
| Критик | менеджер | сводит к ЧИСТО, проверяет, не плодит |
| Генератор | мечтатель | накидывает дикое поле, не терпит критики над собой |
| Переключатель | (был пробел) триггер в скилле | решает, кому сейчас руль |
Продюсера (§4.6) в этой таблице намеренно нет: он живёт на другой оси - не конвергент против дивергента, а альтитуда (задача против продукта), - и в антагонизм критика с генератором не входит. Он конвергентен, как критик, но на этаж выше по объекту.
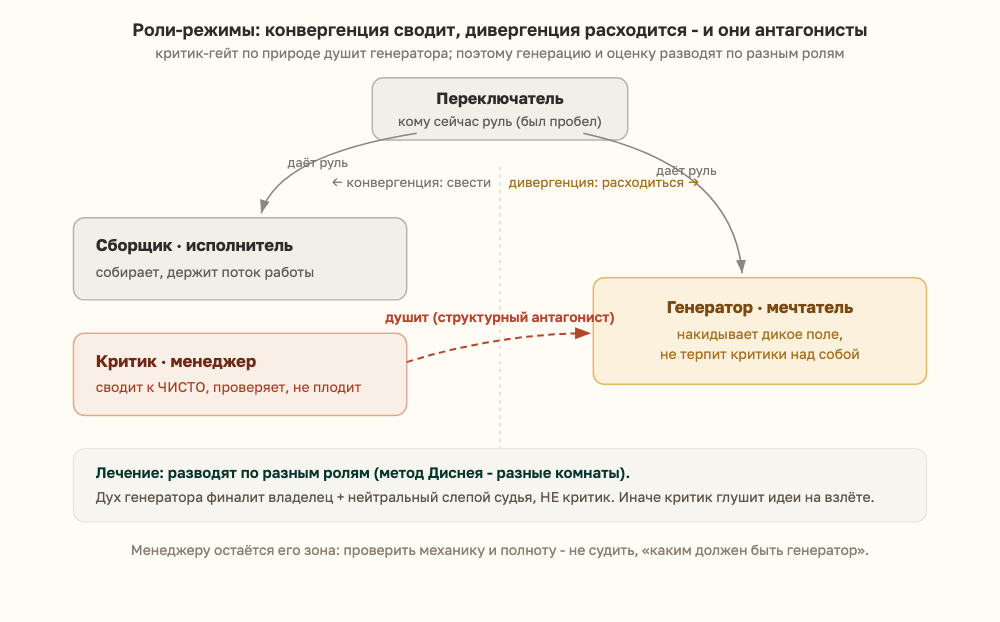
Рис. 4. Четыре роли-режима и их конфликт: конвергентный критик и дивергентный генератор - антагонисты, поэтому генерацию и оценку разводят, а дух генератора судит не критик, а владелец и нейтральный слепой судья.
Конфликт, которого я не ждал. Конвергентное и дивергентное - не просто разные функции, они антагонисты. Критик по природе подавляет генератора («это несерьёзно, займись делом»). Система это воспроизвела буквально: мечтатель 14 раундов сползал в сухого аналитика, потому что каждый раунд его судил конвергентный гейт (менеджер), а тот по устройству тянет к структуре и «не-плоди». Я строил генератора, отдавая его на суд того, кто по природе против свободной генерации.
Главный методологический сдвиг сессии: нельзя судить роль её структурным антагонистом. Менеджер-критик прекрасен как гейт КОНВЕРГЕНТНОЙ работы (полнота, механика, «готово» не соврало) - но искажён как судья ДИВЕРГЕНТНОГО (дух, тон, «а нужно ли вообще это расхождение»). Поэтому:
- дух/характер дивергентного агента утверждает владелец + нейтральный слепой судья (отдельный агент, не менеджер);
- менеджеру остаётся его конвергентная зона - проверить механику и полноту, не судить, «каким должен быть генератор».
Это не моя находка, а общий закон творческих процессов: правило «откладывай суждение» (defer judgment) - ядро брейнсторминга Осборна (1953) и гилфордовского цикла «дивергенция → потом конвергенция»: генерацию и оценку разводят во времени, иначе критик глушит идеи на взлёте. Я слил их в один гейт - и поймал ровно этот провал. Лечение - разделение: генератор накидывает без критики; отбор приходит отдельным шагом, не от того, кто генерил, и не от того, кто по устройству против генерации.
Кто даёт руль - и почему это слабое звено. В сбалансированной системе кто-то должен чередовать руль между генератором (расхождение) и сборщиком (работа). Такой роли не было - и пока она держится на правиле-триггере, который исполняет конвергентный по природе исполнитель. Поэтому автоматический выход генератору - самое ненадёжное место: систему всё ещё тянет к схождению, и «пора расходиться» легко проскользнёт. Самый надёжный инициатор дивергенции пока - живой владелец. Это честная неразрешённая граница.
Зачем это вообще. Чисто конвергентная система отлично доводит ЗАДАННОЕ, но молчит на вопрос «а что вообще стоит делать». Вернуть дивергенцию - значит вернуть половину работы, которую раньше целиком тащил человек. Но наивно (просто добавить генератор) не выйдет: конвергентная половина задушит дивергентную, если их не развести по ролям и не защитить генератора от суда его антагониста. В этом и есть главный неочевидный урок: автономная система, которая умеет и проверять, и порождать новое, - это не сумма двух механизмов, а корректно проведённая граница и баланс между ними.
Родственные идеи и источники
Почти все узлы выше я выводил из своих логов, а не из статей - но, выписав их, увидел, что каждый ложится на уже названный в литературе паттерн. Это скорее независимое переоткрытие, и само совпадение - хороший знак: рабочая система сходится к тому же, к чему пришли исследования. Если строите своё - вот карта, куда смотреть.
Откуда узлы (что эта система, по сути, повторяет):
- Отдельный гейт вместо самопроверки. Интроспективная самокоррекция без внешнего сигнала ненадёжна (Huang et al., 2023), а LLM-судья льстит себе - self-enhancement bias (Zheng et al., 2023); отсюда критик в отдельном окне. Сверка с внешним инструментом, а не с собой - CRITIC (Gou et al., 2023).
- Петля «сделал → оценил → поправил». Паттерн evaluator-optimizer из «Building Effective Agents» (Anthropic), Reflexion (Shinn et al., 2023), Self-Refine (Madaan et al., 2023).
- Дешёвый суррогат + лестница моделей. Каскад FrugalGPT (Chen, Zaharia, Zou, 2023) и паттерн routing: качество держит обвязка, а не верх лестницы.
- Диспетчер и роли. Orchestrator-workers (Anthropic) и ролевые SOP MetaGPT (Hong et al., 2023).
- «Принципы вместо инструкций». Линзы как конституция критика - Constitutional AI (Bai et al., Anthropic, 2022).
- Решать самому или передать человеку. Learning to defer (Mozannar & Sontag, 2020) - формальная рамка различителя масштаба.
- Правила из поведения, не из слов. Revealed preference (Samuelson, 1938) и behavioral cloning.
- Сколько проверять. Калибровка «знать, чего не знаешь» (Kadavath et al., 2022) - корень verify-термостата.
- Память и рефлексия агента. Поток памяти + рефлексия в Generative Agents (Park et al., 2023) - тот же по духу слой, что аудиторский ledger и экстернализация контекста (§8).
- Что фронтир печёт в веса - а обвязка делает в рантайме. Верификаторы решений (Cobbe et al., 2021), пошаговая process-супервизия (Lightman et al., 2023), масштабирование test-time compute (Snell et al., 2024) - обучающие механизмы, чьи рантайм-эквиваленты здесь: гейт с линзами, ПЛАН-стадия, петля раундов, веер, проверяемое «готово» (§7).
- Дивергенция против конвергенции. Guilford (1950-е), правило «отложи суждение» Осборна (1953), метод Диснея «мечтатель/реалист/критик» (Dilts, 1994), «множественное я» от Минского (1986) до мульти-агентного спора (Du et al., 2024).
- Само-обучение агента на своих провалах. Слой уроков (§4.5, целиком - в отдельной статье) стоит на уже названном кусте: постоянная память между сессиями и офлайн-консолидация логов в паттерны (memory tool и Claude Dreaming у Anthropic), уроки-эвристики из траекторий вместо сырых логов (ExpeL, ERL), известный провал масштабирования, когда память правят равномерно и она пухнет (A-MEM), карантинный gated-write и governance эволюционирующей памяти (D-MEM, SSGM). А Reflexion (Shinn et al., 2023) и Generative Agents (Park et al., 2023) из списков выше - прямые соседи по духу: вербальная рефлексия между попытками и поток памяти с рефлексией.
Соседний жанр - SOUL.md. Та же базовая идея «вынести неявный внутренний слой в переносимый документ», но с другого конца: SOUL.md описывает идентичность самого ИИ (ценности, границы, голос), а мой кернел выносит операционную подпись человека в обвязку агента. Один формат артефакта, противоположный субъект - полезно держать оба в голове, когда решаешь, что именно стоит вынести в файл.
Честная граница. Я не реализовывал эти работы по списку - пришёл к узлам из практики, а ссылки расставил постфактум. Поэтому соответствия - на уровне паттерна и духа, не дословной реализации; где мой механизм расходится с оригиналом (диспетчеризация живым сканом вместо зашитых ролей; порог deferral из линз, а не из обучения), я это отметил по тексту.
Заключение
Переносится не «я» - переносится операционная система: способ решать мелкие развилки и способ не доверять собственному «готово». Этого достаточно, чтобы агент работал по моим правилам и давал результат, похожий на мой там, где похожесть важна. Разложил её на три слоя - дешёвый движок выбора, независимый менеджер-гейт и сессионный режим оркестровки - и заложил в каждый одни и те же линзы, собранные не из самоописания, а из следов реального поведения.
Результат - то, что я по опыту и называю «эффективно и дёшево»: дорогое внимание под жёсткой защитой, дешёвая проверка как расходник, ничего не забывается между раундами, и «готово» означает проверенное. Вкус и видение остаются за мной - ровно там, где они и должны быть. А стенд добавил к этому второе дно: раз качество держит обвязка, по лестнице моделей можно спускать каждый слой - и получать фронтир-результат без фронтир-модели, медленнее, но дешевле и без зависимости от чужого верха лестницы (§7).
Поверх этого наросли ещё три этажа, и каждый закрывал свою дыру. Мечтатель вернул дивергенцию - и тут же вскрыл конфликт, которого я не ждал: критик-гейт душит генератора, если их не развести по ролям (§11). Продюсер держит продукт в длинных циклах, когда моё внимание ушло на следующее интересное. Это мой типовой провал: сильный старт и смерть на MVP (§4.6). Слой уроков снял пометку «эксперимент» и выдал самый неожиданный вывод всей системы: часть провалов текстом не лечится вовсе, лечит их только исполняемый гейт, стоящий у заявляющего (§4.5).
Направление у всех троих одно и то же, что и у кернела: вынести наружу, в переносимый текст под версионированием, ещё один слой, который обычно живёт только в голове, - способ решать, состояние продукта, память о том, на чём уже обжёгся.
Про рамку, с которой статья начиналась. Перенос принципов - не эзотерика и не «оцифровка личности». Работа того же рода, что регламент для живой команды, только адресат читает буквальнее и не устаёт. Ценность не в модели и не в архитектуре - она в данных о самом себе и в дисциплине их проверять: каждый принцип, попавший в файл, обязан пройти тест «выбрал бы так я» на реальных развилках, иначе он не ваш, а правдоподобный.
Самый переносимый вывод для тех, кто строит агентов под продукты: автономность - это не «агент решает всё», а корректно проведённая граница между тем, что агент закрывает сам, что отдаёт дешёвому суррогату мнения, и что обязан поднять человеку - плюс независимый механизм, который держит эту границу и не даёт «готово» соврать.
Что изменилось в статье
Заголовок и рамка переписаны: речь о переносе рабочих принципов и вкуса в обвязку агентов, метафора клонирования убрана. Плюс два месяца изменений в самой системе.
- Рамка. Убрана метафора клонирования — она обещает фантастику, а речь об инженерной дисциплине: выписать свои принципы и вкус так, чтобы агенты делали по ним верные выводы там, где это важно.
- §4.2 — у гейта девять линз (одна выделена в профильный проход); на входе три оси вместо одной: стадия работы, масштаб задачи, темп; двухфазный проход линз (−18% времени); заявления проверяют команды-гейты.
- §4.3 — сессионный режим переименован; добавлены две ортогональные оси: темп (турбо) и вид работы (креативный); масштаб задачи как регулятор церемонии; план файлом; доставка владельцу через связного, когда он не у экрана.
- Новый §4.7 — штабной этаж: пульт над всеми проектами и представитель штаба, который выносит находку из чужой сессии нарядом, репликой или предложением в очередь согласий.
- §7 — модельная экономика пересобрана под сентябрь 2026: подписочные каналы вместо потокенной оплаты, второй агентный рантайм, живые цифры расхода.
- §4.5 — слой уроков больше не помечен экспериментальным: два месяца боевой работы, база выросла вчетверо.
Первая публикация: движок выбора, менеджер-гейт, сессионный режим, мечтатель, слой уроков, продюсер продукта.