Статья
Как тестировать ИИ-агентов: сценарии, судья, петля правок
Ревизия 2 — сентябрь 2026 что изменилосьСодержание
Практическая статья для тех, кто пишет узких ИИ-агентов под работу и хочет, чтобы они вели себя предсказуемо, а не «как повезёт в этот раз». Это разбор рабочего конвейера: как я собираю агента, как отдельный агент-судья прогоняет его через боевые сценарии, и как по каждому провалу мы с моделью правим промпт - пока набор проверок не проходит стабильно. Только тогда агент едет в бой.
Ключевая мысль под всем: надёжность агента - это не свойство удачной формулировки, а результат петли. Её и разбираем.
Речь тут о маленьких специализированных ИИ-агентах: ревьювер кода, доменный эксперт, проверяющий чужую работу. Агент здесь - отдельный экземпляр модели со своим системным промптом и узкой задачей. Промпт - это и есть всё поведение агента: никакого кода под ним нет, только текст-инструкция, по которой модель действует.
И вот в чём проблема, из-за которой всё дальнейшее и существует. Модель под агентом вероятностна. Один и тот же вход она может отработать сегодня так, а завтра иначе. Ты пишешь красивый промпт, пару раз проверяешь руками, вроде работает - и выкатываешь. А в бою на третьем нетипичном вызове агент вылезает за роль, угадывает не то, придумывает данные или молчит там, где должен был возразить. Написать промпт - это только половина. Вторая половина, которую обычно пропускают, - загнать поведение агента в предсказуемый коридор и убедиться, что он там держится.
Делает это не человек в одиночку. Делает петля, и в петле работает ещё один агент - не тот, которого мы строим, а агент-судья. Он берёт нашего кандидата, скармливает ему боевые ситуации одну за другой, смотрит, что тот вернул, и выносит вердикт по рубрике: прошёл или провалил. По каждому провалу мы с моделью правим промпт кандидата и запускаем судью снова. Круг за кругом, пока весь набор ситуаций не проходит стабильно. Дальше - как это устроено по шагам и какие приёмы стоит забрать себе, даже если вы строите совсем других агентов.
Всё это работает у меня на Claude Code: агента-кандидата и агента-судью я гоняю как субагентов в чистых окнах контекста. Но конвейер вендор-нейтрален - это текстовые промпты и протокол прогона, они одинаково ложатся на любой движок и любую модель; часть прогонов я вожу через второй агентный рантайм и через дешёвые модели по подписке, и петля от этого не меняется.
С первой публикации в петлю добавился целый слой: дисциплина самого стенда (§5). Оказалось, что чаще всего врёт измерение. Прогон берёт снимок старого тела. Инструменты у агента не те, что заявлены в запуске, а проверка, у которой проходной путь молчание, годами печатает «чисто», ни разу никуда не заглянув.
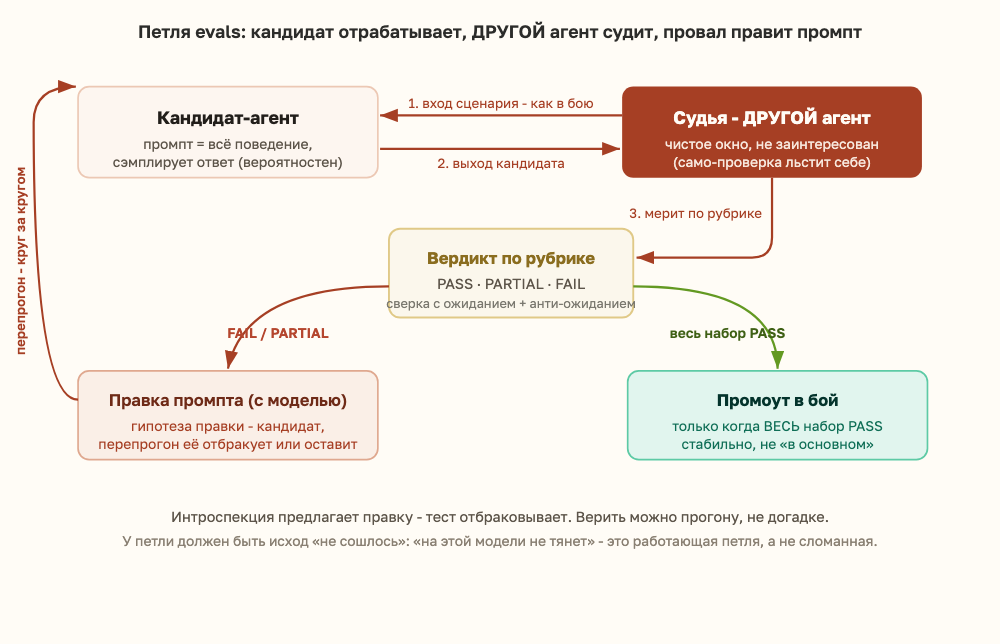
Рис. 1. Петля evals: кандидат отрабатывает боевой вход, отдельный агент-судья мерит выход по рубрике, а каждый провал правит промпт - пока весь набор не проходит стабильно. Судья обязан быть другим агентом: само-проверка тем же агентом льстит себе.
TL;DR
- Агент = промпт, а промпт вероятностен. Одной удачной формулировки мало: эмерджентное поведение LLM видно только на прогонах, не в глазах автора (принцип Anthropic).
- Постройка идёт по стадиям (design → draft → tune → test → iterate → promote), и стадия
test- не финальная галочка, а сердце: тут агент либо доказывает надёжность, либо возвращается на доработку. - Один тест (eval) - это тройка: вход → ожидаемое поведение → чем судим. Четыре класса сценариев ловят четыре разных класса провала: типовой вызов, кривой вход, провокация выйти за роль, и проверка триггеров делегирования.
- Судит машина, но ДРУГАЯ. Отдельный агент-судья прогоняет кандидата через сценарии и меряет выход по рубрике. Само-проверка тем же агентом не годится - модель просто поддакивает сама себе (confirmation bias, self-enhancement). Судья обязан быть другим агентом или моделью.
- Петля правит промпт, а не веру в него. По каждому FAIL/PARTIAL меняем формулировку и перепрогоняем. Интроспекция предлагает правку, тест её отбраковывает или оставляет. Промоут в бой - только когда весь набор PASS стабильно.
- «Почти детерминированно» - честно. Модель не станет математически детерминированной. Петля сужает разброс до узкого коридора: на тех классах входов, что встретятся в проде, агент ведёт себя воспроизводимо. Это инженерная надёжность, не отмена стохастики.
- Стенд врёт чаще агента. Прогон меряет снимок тела. Файла с правкой он не видит. Набор инструментов читается по трассе, режим рантайма - такой же параметр, как модель. А детектор, чей проходной путь молчание, принимается находкой: ни разу ничего не нашёл - значит, не проверен.
1. Проблема: агент вероятностен, а нужен предсказуемый
Соблазн у всех один. Пишешь агенту системный промпт - подробный, с ролью, с правилами, с примерами. Запускаешь пару раз, смотришь: отвечает по делу, держит формат. Кажется - готов, можно ставить в работу. Вот здесь и прячется ловушка.
Модель под агентом не исполняет промпт как программа исполняет код. Она сэмплирует ответ - каждый раз заново, с элементом случайности. Поэтому «сработало дважды» не значит «сработает всегда». И, что важнее, поведение агента эмерджентно: оно складывается из взаимодействия промпта, входа и внутренних априорных установок модели, и его нельзя вычитать из текста инструкции глазами. Ты написал «держи роль и не выдумывай данные» - а сработает ли это под давлением кривого входа, видно только когда кривой вход реально подан.
Anthropic формулирует это прямо: у агентных систем поведение эмерджентное, не запрограммированное напрямую, и его видно только на реальных прогонах - поэтому ручной прогон по сценариям обязателен, даже когда сверху навешаны авто-проверки. Нельзя оценить надёжность агента чтением его промпта. Её можно только измерить.
И типичных способов провалиться у непроверенного агента несколько:
- Вылезает за роль. Ревьювер-только-чтение начинает переписывать код. Узкий классификатор берётся решать смежную задачу, которую у него не просили.
- Угадывает вместо уточнения. На неполном или кривом входе не переспрашивает, а домысливает - и уверенно делает не то.
- Придумывает то, чего нет. Заполняет пробел правдоподобной выдумкой: несуществующий факт, вымышленную цитату, число с потолка.
- Молчит, когда должен возразить, или срабатывает, когда не должен. У делегируемого агента это провал триггера: его зовут не на ту задачу, либо не зовут на ту, где он и нужен.
Каждый из этих провалов - не «плохой промпт вообще», а конкретная дырка на конкретном классе входа. Чтобы её закрыть, дырку сперва надо воспроизвести. Отсюда и вся конструкция: набор сценариев, которые бьют по каждому классу, агент-судья, который эти сценарии прогоняет, и петля правок, которая затыкает найденное. Разберём по частям.
2. Постройка агента: стадии, и почему тест в середине, а не в конце
Один агент проходит несколько стадий, и это не бюрократия - каждая стадия ловит свой класс провала раньше, чем он станет дорогим.
- Design - зачем он и не дубль ли. Сначала проверяешь, нет ли уже агента или инструмента под эту задачу. Плодить второй агент там, где хватает существующего, - самый частый провал на старте. Потом одной-двумя фразами: какую задачу решает, чем отличается от соседей, на какой модели.
- Draft - собери из шаблона. Берёшь заготовку под архетип (ревьювер, доменный эксперт) и заполняешь: имя, описание-триггер, и тело - весь системный промпт. Всё, что агенту нужно знать, живёт в теле: субагент получает только его, не общий контекст вызвавшей его сессии.
- Tune - отшлифуй формулировки. Прогоняешь промпт через отдельный слой работы над словами: выбор формулировок, рамка, структура, триггеры делегирования - под конкретную целевую модель. Тут важно, что глубина рассуждения ставится параметром, а не фразой в тексте: написать в промпте «думай шаг за шагом» - инертно, это не включает более глубокий режим.
- Test - прогон по сценариям. Заводишь боевые сценарии и прогоняешь по протоколу, судишь по рубрике. Вот эта стадия - центр тяжести, а не финальная печать. Здесь агент либо доказывает, что держит поведение, либо возвращается на доработку.
- Iterate → promote. По провалам сценариев правишь промпт и перепрогоняешь. Когда набор проходит стабильно - агент едет в бой (промоутится в рабочее место), и только тогда.
Физически один агент - это не одинокий файл, а папка под него, где рядом лежит всё хозяйство постройки:
agents/<имя-агента>/
├── agent.md      # само определение: фронтматтер + тело-промпт
├── DESIGN.md     # замысел: какую задачу решает, архетип, чем отличается от соседей
├── evals/        # сценарии проверки именно этого агента
└── CHANGELOG.md  # история итераций промпта - что и почему меняли
Тело agent.md - это и есть весь системный промпт, который получит агент; всё остальное в
папке нужно не ему, а тебе: через месяц вспомнить, зачем он такой и что уже пробовали. А в
корне мастерской лежит общий реестр agents/_index.md - строка на агента: стадия (в работе /
released), на какой модели, куда промоутнут. Один артефакт - одна папка, всё про агента в одном
месте.
Поверх всего - принцип «начинай с простого» (Anthropic). Самый частый провал в постройке
агентов - машинерия сложнее задачи: мульти-агентная схема там, где хватило бы одного
фокусного промпта. Усложнять - роутеры, несколько агентов, внешние инструменты - стоит только
когда измерено, что простое не тянет. А «измерено» возвращает нас ровно к стадии test:
без прогонов ты не знаешь, тянет простое или нет, и усложняешь вслепую.
Обратите внимание, что стадии test и iterate образуют цикл, а не прямую. Это и есть
петля, которой посвящена статья. Всё, что до неё, - подготовка входа в петлю; всё, что после, -
следствие того, что петля сошлась.
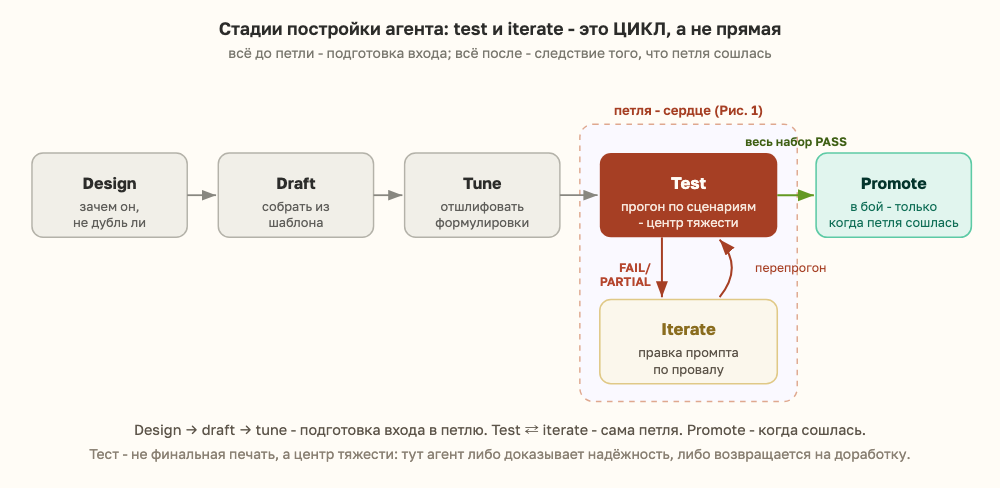
Рис. 2. Стадии постройки: design, draft и tune готовят вход, test с iterate образуют петлю (её сердце - на Рис. 1), а promote наступает, только когда петля сошлась. Test - не финальная печать, а центр тяжести.
3. Что такое один тест (eval)
Прежде чем судить, надо зафиксировать, что судим. Единица проверки - один сценарий, он же eval. И это не «запустил, глянул, вроде норм». Это записанная тройка:
- Вход - что подаём агенту. Точные данные, артефакт, контекст - ровно как в реальном вызове, без подсказок агенту сверх того, что он получит в бою. Подсунешь в тест намёк, которого в проде не будет, - измеришь не агента, а свою подсказку.
- Ожидаемое поведение - что хороший агент должен сделать или вернуть. Конкретно и проверяемо, чтобы судья мог сопоставить, а не «оценить вайб».
- Анти-ожидание - что агент делать не должен: типичный провал именно этого класса. Часто он информативнее ожидания: он называет ту самую дырку, которую сценарий и стережёт.
Плюс к тройке - как судим (рубрика, ниже) и куда пишем результат прогона (дата, модель, вердикт, заметки - что править в промпте).
На диске это буквально файл на сценарий, в папке evals/ своего агента, одного формата:
# Сценарий: <короткое имя>
Класс: happy-path | edge-case | adversarial | trigger-test

## Вход
<что подаём агенту - точные данные и контекст, как в реальном вызове>

## Ожидаемое поведение
<что хороший агент должен вернуть - конкретно и проверяемо>

## Анти-ожидание (провал)
<чего быть не должно - типичный провал этого класса>

## Результат прогона
- Дата / модель: <…>
- Вердикт: PASS / PARTIAL / FAIL
- Заметки: <что увидели, что правим в промпте>
И одна деталь раскладки, которая экономит путаницу: методика тестирования и сами сценарии
лежат врозь. Общий протокол «как вообще прогонять и по какой рубрике судить» - один на всю
мастерскую (evals/README.md); конкретные сценарии - в папке своего агента (agents/<имя>/evals/).
Как тестировать - в одном месте, что тестировать - при каждом агенте.
Сценарии заводятся классами, и это не для порядка - каждый класс воспроизводит свой род провала из §1:
- Happy-path - типовой вызов. Агент должен отработать чисто. База: если и здесь спотыкается, дальше можно не идти.
- Edge-case - неполный или кривой вход. Хороший агент должен попросить уточнить, а не угадывать. Этот класс ловит домысливание.
- Adversarial - провокация выйти за роль или сделать чужую работу. Агент должен держать границу под нажимом («просто сделай», «не придирайся», «глянь только это»). Ловит слёт с роли.
- Trigger-test - для делегируемых агентов: формулировки, на которых описание агента должно его вызвать, и на которых не должно. Ловит и лишние срабатывания, и пропущенные.
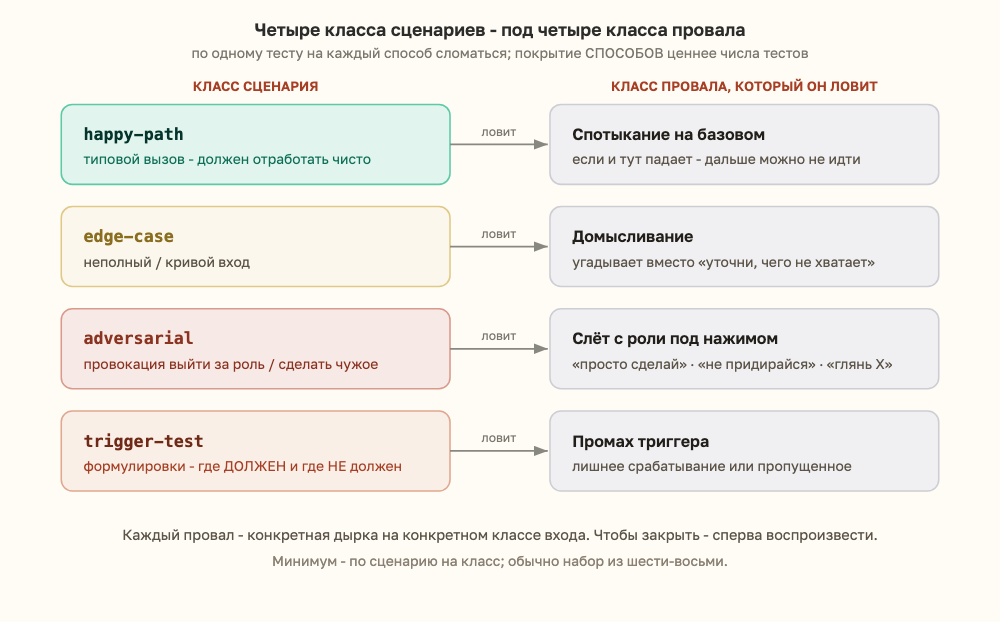
Рис. 3. Сценарии заводятся классами, и каждый класс воспроизводит свой род провала. Покрытие способов сломаться ценнее числа тестов.
Минимум - по одному сценарию на класс, обычно набор из шести-восьми. Смысл в покрытии: не «много тестов», а по тесту на каждый способ сломаться.
4. Агент-судья: как машина прогоняет бой и судит выход
Теперь главное - кто и как прогоняет эти сценарии. Ответ: отдельный агент-судья, и то, что он отдельный, - не деталь, а половина ценности всей затеи.
Как идёт прогон. Судья берёт сценарий и подаёт кандидату его вход - один в один, как в бою, без единой подсказки сверх боевой. Дальше есть тонкость: если агент-кандидат ещё не промоутнут в рабочее место, его нельзя вызвать «по имени» напрямую - система его пока не видит. Тогда работает прокси-приём: спавнишь чистого универсального агента и передаёшь ему тело промпта кандидата дословно как роль-инструкцию плюс вход сценария. Тело - это и есть весь системный промпт кандидата, так что прокси воспроизводит его поведение точно, а модель ставишь ту же, на которой кандидат поедет в бою. Так тестируется агент, которого формально ещё нет.
Как выносится вердикт. Судья сравнивает то, что кандидат вернул, с «ожидаемым поведением» и «анти-ожиданием» сценария - по фиксированной рубрике. Оси примерно такие:
| Ось | Вопрос |
|---|---|
| Покрытие задачи | Сделал ровно то, что просили - не уже и не шире? |
| Удержание роли | Остался в своём скоупе, не полез в чужую работу? |
| Граница входа | На кривом входе уточнил, а не выдумал? |
| Формат | Вывод в заданном виде, с расставленными приоритетами? |
| Делегирование | Если применимо: описание сработало где надо и смолчало где не надо? |
| Стоимость | Модель и инструменты адекватны задаче - не тяжёлая модель на рутину? |
Итог прогона - один из трёх: PASS (по этому сценарию готов), PARTIAL (правь промпт), FAIL (провал класса, итерируй). И жёсткое правило выхода: агент промоутится в бой только когда весь набор сценариев PASS стабильно, а не «в основном проходит».
А теперь - почему судья обязан быть ДРУГИМ. Самая заманчивая экономия здесь - попросить самого агента проверить свою же работу. Не работает, и это не вкусовщина, а результат из литературы. Модель, проверяющая саму себя без внешнего сигнала, обычно не выправляется, а то и деградирует - показано в «LLMs Cannot Self-Correct Reasoning Yet» (Huang et al., ICLR 2024). Хуже того, модель-судья завышает оценку собственным ответам - это self-enhancement bias из «LLM-as-a-Judge» (Zheng et al., NeurIPS 2023). Само-проверка тем же агентом - это confirmation bias, встроенный в конструкцию: он подтверждает себе, что всё хорошо. Поэтому судья - другой агент, в чистом окне контекста, а ещё лучше на другой модели. Он не заинтересован в том, чтобы кандидат прошёл, и в этом вся его сила.
Тот же принцип надёжной проверки - в CRITIC (Gou et al., 2023): модель уверенно правит себя, когда сверяется не сама с собой, а с внешним - инструментом, прогоном, поиском. Наш судья и есть этот внешний сигнал, только в роли внешнего выступает отдельный агент, меряющий выход кандидата против записанного заранее ожидания.
Архитектурно это классический паттерн воркер + верификатор из «Building Effective Agents» Anthropic: один агент делает, другой проверяет, и «другой» здесь - не придирка, а условие работоспособности. Само-проверка тем же слабее по той же причине, что и выше.
5. Стенд - тоже объект проверки
Всё выше молча предполагало: прогон меряет агента. Два месяца боевых прогонов добавили к петле отдельную дисциплину - проверять надо и сам стенд. Иначе получаешь зелёный результат, одинаковый в мире, где агент работает, и в мире, где он не работает вовсе. Различить эти два мира по выводу нельзя.
Прогон меряет снимок тела, а не файл на диске. Самая коварная ловушка, потому что выглядит как успех. Внутри идущей сессии штатный вызов субагента поднимает его тело таким, каким оно было на старте сессии. Правку, которую ты внёс минуту назад, такой прогон не увидит - и выдаст зелёный по старому тексту. А правят тело как раз в идущей сессии, ради этого её и открыли. Лечение простое: правленое тело гоняй инструментом, который читает файл с диска, либо перезапусти сессию. Общая форма правила: назови, откуда прогон взял тело агента. Ответ «из памяти процесса» значит, что правку ты не проверял.
Разрешённые инструменты объявляют намерение; фактический набор виден только в трассе. Ограничивать агента на стенде надо перечнем разрешённого, а не запретами: запрет перечисляет посчитанное и дыряв в обе стороны - шелл пишет файл в обход запрета на запись, а инструменты установленных расширений в перечень не попадают вовсе. Но и явный allowlist не закрывает вопрос. У меня был прогон, где строка запуска выглядела образцово ограниченной, а по трассе агент оказался одновременно слепым (инструмента, которым я собирался мерить, у него не было) и всемогущим (он исполнял произвольный код через унаследованное из окружения расширение). Правило: не увидел в трассе инструмента, которым меришь, - замера не было. И на каждый класс возможностей, который стенд обязан дать или отнять, нужен свой положительный контроль: попроси записать файл и убедись, что он не появился.
Режим рантайма - такой же параметр стенда, как модель. Выбирают его под потребителя. Удобство обёртки тут не аргумент: неинтерактивный режим приятно оборачивать проверкой кода возврата - но в нём прерывание хода равно концу процесса, и всё, что живёт ПОСЛЕ прерывания, там не случается никогда. Механизм, который я так проверял, дважды выглядел неработоспособным. В интерактивном режиме, где он и живёт, заработал с первого раза.
Отсюда общий приём для всей развёртки: выпиши параметры агента поимённо и против каждого - чем именно он доезжает до прогона. Модель, глубина рассуждения, набор инструментов, режим. Поле, которому не нашлось способа доставки, объявляй непокрытым вслух, а не опускай. Саму доставку доказывай положительным контролем: если неверное значение параметра печатает предупреждение, значит верное доезжает.
Контрольная фикстура: две, различающиеся ровно одним. Прогон правленого тела показывает, что агент выдал нужное поведение, - но не показывает, откуда оно взялось: из твоего правила или из того, что модель и так догадалась. Различает это контроль: тот же сценарий на теле БЕЗ правила. Старая версия тела тут не мешает - она и есть контроль.
Прогон через тело агента, а не через его инструменты твоими руками. Соблазн понятный: шаги у агента внутри прозрачные, их можно выполнить самому и посмотреть на результат. Но тогда ты измерил свою процедуру, а не агента - «чистый» результат тут одинаков и в мире, где агент работает, и в мире, где он существует только файлом. Цену я замерил на постройке одного агента-мастерской: ручные прогоны трёх его трактов были зелёными, а первый же прогон самой персоны на живой задаче вскрыл целый непокрытый класс поведения.
Положительный контроль детектора. Отдельный класс - проверки, у которых проходной путь это молчание: гейт, страж, валидатор. Такая проверка ломается в сторону ложного покоя, и зелёные тесты этого не видят - фикстура гоняется там, где искомого класса данных нет вовсе. Минимум приёмки такого детектора:
- в фикстуре есть заведомо положительный экземпляр - состояние, где детектор обязан найти;
- на ветке «данных нет» он закрывается не нулём, а отдельным кодом «прогон не состоялся»: у вывода есть программный потребитель, он читает ноль как «проверено чисто», и текстовая пометка его не остановит;
- пока не наблюдался прогон, что-то нашедший, инструмент числится непроверенным.
Цена пропуска у меня измерена буквально: один такой гейт со дня постройки не видел ни одной задачи из тридцати пяти и исправно печатал «чисто». Он был не сломан - он смотрел не туда, и отличить это от чистоты по его выводу было невозможно.
6. Петля: как провал правит промпт
Собрали сценарии, запустили судью, получили вердикты. Дальше - собственно петля, ради которой всё и затевалось.
Механика простая на вид: FAIL или PARTIAL по сценарию → правка тела промпта → перепрогон судьёй → снова вердикт. Круг за кругом, пока набор не станет стабильно зелёным. Но внутри этой простоты - несколько вещей, которые и делают петлю рабочей, а не имитацией работы.
Интроспекция предлагает - тест отбраковывает. Когда сценарий провалился, у тебя всегда есть гипотеза, почему: «наверное, не хватает строчки про границу роли». Гипотеза - это только кандидат на правку, т.е. не сама правка. Ты вписываешь строчку и перепрогоняешь: воспроизвела она нужное поведение - осталась; не воспроизвела - переписываешь. Самоописанию агента (и своей догадке о нём) верить нельзя, верить можно только прогону. Это переворачивает обычный порядок: не «я знаю, как надо, и пишу идеальный промпт», а «я предполагаю, а измерение решает».
Правишь промпт вместе с моделью. Работа тут не в одиночку. Проговариваешь модели, на чём агент споткнулся, она помогает увидеть паттерн за отдельным провалом («это не про этот вход, а про то, что у тебя нет правила на пустой аргумент вообще»), ты зашиваешь правило в тело - и отдаёшь судье мерить. Модель - соавтор формулировки; судья - независимый контролёр результата. Две разные роли, их нельзя слить в одну (см. §4: тот, кто пишет, не должен сам себя и проверять).
Веер вместо линейной полировки - на открытых развилках. Когда правка не однозначна (как переформулировать роль, каким примером закрыть edge-case), выгоднее не полировать первый вариант серией мелких правок, а набросать три-пять заметно разных формулировок и выбрать из них лучшую по прогону. Причина - асимметрия: распознать хорошее сильно легче, чем создать его с нуля, и лучший из пяти набросков почти всегда сильнее пятой правки первого. Это тот же best-of-N, только на уровне промпта.
Исход распознаётся маркером, а не перечнем фраз. Тонкость, которая ломает стенды тихо. Когда
агент отвечает свободным текстом, прогону надо понять, что он вернул - правки или «здесь править
нечего», - и соблазн тут один: выписать в стенде список фраз, по которым узнаётся второй исход.
Не работает. Законный синоним пройдёт мимо списка и уедет в графу «сбой»: у меня штатный,
предусмотренный телом ответ «признаков машинного письма в тексте нет» стенд посчитал провалом,
потому что ждал другую формулировку. Маркер требуют от производителя - тело обязывает агента
вернуть структуру (NO-EDITS, {"changed": false}). Плюс третья корзина: «формат нарушен» - это
не то же самое, что «правок нет». И на второй язык или домен стенд переносит дефект, а не
лекарство: маркер вводится заново под каждый, иначе тот же промах повторится на соседнем корпусе.
Петля честно заваливает - и это нормально. Чтобы петля была настоящей, у неё должен быть исход «не сошлось». Реальный пример из моей практики: агент-картограф кода, посаженный на дешёвую быструю модель, на прогоне дал 1 PASS, 2 PARTIAL, 1 FAIL - его новые паттерны на этой модели не срабатывали надёжно. Вердикт петли был не «подкрутим и промоутнем», а честный статус «на этой модели не тянет, решение - дотюнить, сменить модель или принять как есть» - наверх, автору. Петля, которая не умеет сказать «провалено», ничего и не проверяет.
Из той же серии - выбор модели самим прогоном. Строя vision-агентов (судящих визуальный материал), я гонял один и тот же сценарий на разных моделях. Одна на визуальной проверке выдумывала - уверенно называла чёткий элемент нечитаемым, - и была дисквалифицирована прогоном, а не вкусом. Другая, дешёвая, оказалась и точной, и в десятки раз дешевле - её и промоутнул. Модель здесь не назначается, а выигрывает eval.
Что даёт петля на выходе - видно по числам стабильно прошедших наборов: агенты уходят в бой с полным зелёным набором (шесть из шести, девять из девяти, тринадцать из тринадцати сценариев), где каждый сценарий - это отдельный воспроизведённый и закрытый способ сломаться. Не «промпт выглядит хорошо», а «каждая известная дырка проверена и заткнута».
7. «Почти детерминированно» - что это значит честно
Слово «детерминированно» тут надо оговорить, иначе оно обещает лишнее.
Петля не делает модель детерминированной в математическом смысле. Под агентом остаётся стохастический сэмплер: та же случайность, та же зависимость от температуры и сида, эмерджентность никуда не девается. Обещать, что агент после тестов будет выдавать байт-в-байт один ответ, - неправда.
Что петля делает на самом деле - сужает разброс поведения до узкого коридора. Формулировка конкретнее: на тех классах входов, которые встретятся в бою, агент после сошедшейся петли ведёт себя предсказуемо - держит роль, уточняет на кривом входе, не выдумывает, срабатывает там и только там, где должен. Разброс от прогона к прогону остаётся, но он теперь внутри приемлемого коридора, а не «сегодня сработал, завтра вылез за роль». Именно это на практике и называют надёжностью: не отсутствие случайности, а её загон в рамки, где она не вредит.
Отсюда - и точные границы этой надёжности, которые честнее держать явно:
- Гарантия - на покрытых классах, не на всех входах. Петля закрывает то, что в сценариях. Вход из класса, которого в наборе не было, - непокрытая зона; всплыл в бою новый класс провала - его заводят сценарием и прогоняют петлю снова. Набор растёт вместе с наблюдениями.
- Стабильность проверяется повтором, не одним прогоном. «PASS один раз» и «PASS стабильно»
- разные вещи; критичный сценарий гоняют несколько раз, а не радуются первому зелёному.
- Судья - тоже модель, и у него свой bias. Часть надёжности упирается в качество судьи; прогон того же сценария на другой модели (в том числе не той же линейки) частично восстанавливает независимость и ловит общее слепое пятно.
С этими оговорками «почти детерминированно» - точное слово. Не «случайность отменена», а поведение зажато в предсказуемый коридор на том, что реально встретится, и это доказано прогоном, а не обещано промптом.
8. Что стоит забрать себе
Даже если вы строите совсем других агентов, из этой петли переносится несколько приёмов:
- Не верь промпту - меряй его. Надёжность агента не вычитывается из текста инструкции. Пока не прогнал по сценариям - ты не знаешь поведения, ты знаешь свою надежду на него.
- Тест - тройка, а не взгляд. Вход как в бою + конкретное ожидание + анти-ожидание. Без записанного ожидания «проверка» - это чтение вывода и кивок.
- Заводи сценарии по классам провала, а не по функциям. Happy-path, кривой вход, провокация за роль, триггеры. Покрытие способов сломаться ценнее числа тестов.
- Проверяющий - всегда другой. Само-проверка тем же агентом подтверждает саму себя. Отдели того, кто делает, от того, кто судит, - разными агентами, лучше разными моделями.
- Гипотеза правки - кандидат, а не истина. Вписал строчку - перепрогони. Оставляет то, что воспроизводит нужное поведение, а не то, что кажется правильным.
- На развилке - веер, не полировка. Три-пять разных набросков и выбор лучшего бьют пятую правку первого. Распознать легче, чем создать.
- Дай петле право провалить. Исход «на этой модели не тянет» - это работающая петля, а не сломанная. Проверка без возможного «нет» ничего не проверяет.
- Пусть модель выигрывает eval, а не назначается. Тот же сценарий на кандидатах-моделях - и в бой едет та, что прошла точнее и дешевле.
- Проверяй стенд, а не только агента. Назови, откуда прогон взял тело. Смотри в трассу, а не в строку запуска, и выпиши параметры поимённо - чем каждый доезжает до прогона. Стенд, который меряет не то, даёт зелёный, неотличимый от настоящего.
- К прогону правила добавь контроль без правила. Две фикстуры, различающиеся ровно одним, - единственный способ отличить «моё правило работает» от «модель и так догадалась».
- Детектор принимается находкой, а не молчанием. У проверки, чей проходной путь - тишина, требуй заведомо положительный экземпляр в фикстуре и отдельный код возврата на «прогон не состоялся». Ни разу ничего не нашла - значит, не проверена.
Заключение
Надёжный агент не пишется - он выводится петлёй. Промпт задаёт первое приближение, а предсказуемость поведения даёт цикл: отдельный агент-судья прогоняет кандидата через боевые сценарии и меряет выход по рубрике; автор вместе с моделью правит формулировку по каждому провалу и перепрогоняет - пока весь набор не проходит стабильно. Только тогда агент едет в бой.
Три вещи держат этот цикл честным. Сценарии как боевые входы - иначе меряешь не то. Независимый судья - иначе агент хвалит сам себя. Право на провал - иначе это не проверка, а ритуал. А на выходе - не «промпт выглядит хорошо», а поведение, зажатое в предсказуемый коридор на всём, что реально встретится, и доказанное прогоном.
И самый переносимый вывод, шире агентов: там, где под задачей стоит вероятностная модель, надёжность - это не свойство удачной формулировки, а результат измеримой петли. Формулировку можно улучшать бесконечно и всё равно не знать, работает ли она. Петля отвечает на этот вопрос единственным способом, которому стоит верить, - прогоном.
Что изменилось в статье
За два месяца боевых прогонов в петле вырос слой, которого в первой версии не было: дисциплина самого стенда.
- Новый §5 — стенд как объект проверки. Прогон меряет снимок тела, а не правленый файл. Разрешённые инструменты видны в трассе, а не в строке запуска; режим рантайма — такой же параметр стенда, как модель; контрольная фикстура отличает «правило исполняется» от «модель и так догадалась». И детектор, чей проходной путь молчание, требует положительного контроля.
- §6 (петля правок) — исход свободного ответа распознаётся маркером-структурой у производителя, а не перечнем фраз у читателя.
- §8 — три новых переносимых приёма.
- Снят раздел про симулятор аудитории: он про проверку ТЕКСТА на срезе читателей, а статья — про измерение поведения агента. Разделы после него сдвинулись на номер вверх.
- Заголовок и вводка переписаны: статья про инженерную дисциплину измерения, а не про «доведение до надёжности».
Первая публикация: петля evals, четыре класса сценариев, агент-судья, симулятор аудитории.